
Bạn viết xong một bài chuẩn SEO, bấm đăng, rồi mở Google Search Console sau một tuần và thấy dòng chữ quen thuộc: “Đã phát hiện – hiện chưa được lập chỉ mục”. Bài viết tồn tại, sitemap có URL đó, nhưng Google vẫn chưa đụng tới. Nguyên nhân gần như luôn nằm ở một nhân vật vô hình: Googlebot.
Rất nhiều người làm SEO tối ưu title, meta description, mật độ từ khóa rất kỹ nhưng lại bỏ qua câu hỏi gốc rễ: con bot của Google thực sự nhìn thấy gì trên website của mình, và nó quyết định ghé thăm dựa trên cái gì? Khi không trả lời được câu hỏi đó, mọi tối ưu on-page phía sau đều là xây nhà trên nền cát — nội dung hay đến mấy mà Googlebot không crawl được thì cũng không bao giờ có thứ hạng.
Bài viết này sẽ giải thích Googlebot là gì theo đúng cơ chế kỹ thuật thật, bóc tách quy trình bốn giai đoạn Crawl → Render → Index → Rank, chỉ ra cách kiểm tra Googlebot có đang ghé website bạn hay không, phân biệt Googlebot thật với bot giả mạo, và đưa ra lộ trình 30 ngày cụ thể để cải thiện tốc độ thu thập dữ liệu.
Googlebot là gì?
Googlebot là chương trình thu thập dữ liệu tự động (web crawler) của Google, có nhiệm vụ đi theo các đường link trên internet để khám phá URL mới, tải nội dung trang về, và gửi dữ liệu đó vào hệ thống xử lý của Google. Nói ngắn gọn: Googlebot là “đôi chân” của Google, còn hệ thống index và thuật toán xếp hạng là “bộ não”.
Điểm quan trọng mà nhiều người hiểu sai: Googlebot không xếp hạng website. Nó chỉ làm đúng một việc là thu thập. Việc đánh giá chất lượng, so sánh với đối thủ và quyết định vị trí trên SERP thuộc về hệ thống thuật toán xếp hạng của Google chạy phía sau. Hiểu rõ ranh giới này giúp bạn chẩn đoán vấn đề chính xác hơn: trang không được index là bài toán của Googlebot, còn trang được index mà thứ hạng thấp là bài toán của thuật toán và chất lượng nội dung — hai vấn đề hoàn toàn khác nhau, cần hai cách xử lý khác nhau.
Googlebot hoạt động theo nguyên tắc nào?
Googlebot vận hành liên tục 24/7 trên hàng nghìn máy chủ phân tán khắp thế giới. Nó duy trì một hàng đợi URL khổng lồ gọi là crawl queue. Mỗi URL trong hàng đợi được gán một mức ưu tiên dựa trên nhiều tín hiệu: mức độ quan trọng của trang, tần suất thay đổi nội dung, số lượng link trỏ tới, và lịch sử crawl trước đó.
Khi tới lượt một URL, Googlebot gửi một HTTP request tới máy chủ của bạn giống hệt như một trình duyệt thật. Nó đọc mã trạng thái trả về (200, 301, 404, 503…), tải HTML, phân tích các thẻ link bên trong, và đưa những URL mới phát hiện được trở lại hàng đợi. Đây là một vòng lặp không bao giờ dừng — đó cũng là lý do một website có cấu trúc link nội bộ tốt sẽ được crawl sâu hơn và thường xuyên hơn hẳn website có các trang “mồ côi” không ai trỏ tới.
Các loại Googlebot bạn cần biết
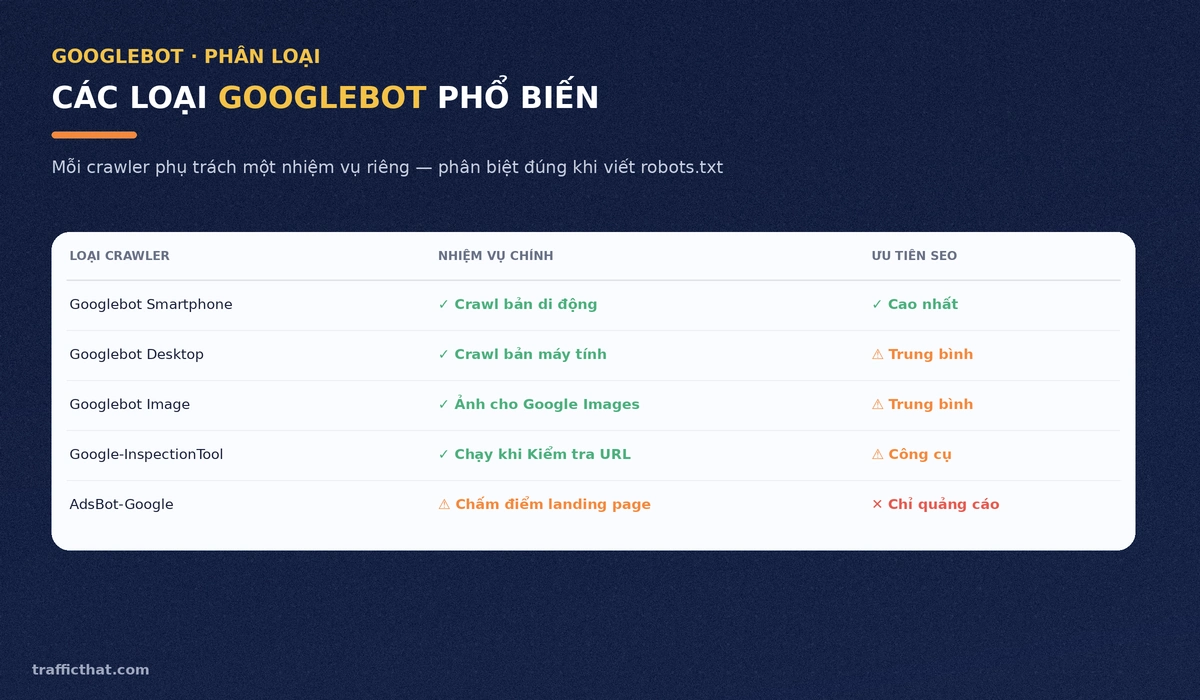
“Googlebot” thực ra là tên gọi chung của cả một họ crawler, mỗi loại phụ trách một nhiệm vụ riêng. Việc phân biệt chúng rất quan trọng khi bạn đọc log máy chủ hoặc viết rule trong robots.txt:
| Tên crawler | Nhiệm vụ chính | Mức độ ưu tiên với SEO |
|---|---|---|
| Googlebot Smartphone | Crawl phiên bản di động của trang — đây là crawler chính từ khi Google chuyển sang mobile-first indexing | Cao nhất |
| Googlebot Desktop | Crawl phiên bản máy tính, hiện chỉ chiếm tỷ lệ nhỏ | Trung bình |
| Googlebot Image | Thu thập hình ảnh phục vụ Google Images | Trung bình |
| Googlebot Video | Thu thập nội dung video | Thấp (trừ site video) |
| Googlebot News | Thu thập bài cho Google News | Thấp (trừ site tin tức) |
| Google-InspectionTool | Chạy khi bạn bấm “Kiểm tra URL” trong Search Console | Công cụ kiểm tra |
| AdsBot-Google | Kiểm tra chất lượng landing page cho Google Ads | Chỉ liên quan quảng cáo |
| Google-Extended | Kiểm soát việc dùng nội dung cho các sản phẩm AI của Google | Tùy chính sách nội dung |
Một lưu ý thực tế rất hay bị bỏ sót: chặn Googlebot Image trong robots.txt không làm giảm thứ hạng bài viết, nhưng sẽ khiến toàn bộ ảnh của bạn biến mất khỏi Google Images — mất trắng một kênh traffic miễn phí. Tương tự, chặn nhầm Google-InspectionTool sẽ khiến công cụ Kiểm tra URL trong Search Console báo lỗi dù trang vẫn crawl bình thường.
User-agent của Googlebot trông như thế nào?
Khi đọc log máy chủ, bạn sẽ thấy chuỗi user-agent dạng này với Googlebot Smartphone: Mozilla/5.0 (Linux; Android 6.0.1; Nexus 5X Build/MMB29P) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/W.X.Y.Z Mobile Safari/537.36 (compatible; Googlebot/2.1; +http://www.google.com/bot.html).
Phần Chrome/W.X.Y.Z là số phiên bản Chrome mà Googlebot đang dùng để render. Từ 2019, Googlebot chạy trên nhân Chromium “evergreen” — tức là luôn cập nhật gần sát bản Chrome ổn định mới nhất. Điều này có nghĩa Googlebot hiện hỗ trợ hầu hết tính năng JavaScript và CSS hiện đại, khác hẳn thời kỳ trước đó khi nó mắc kẹt ở Chrome 41 và không chạy được nhiều framework.
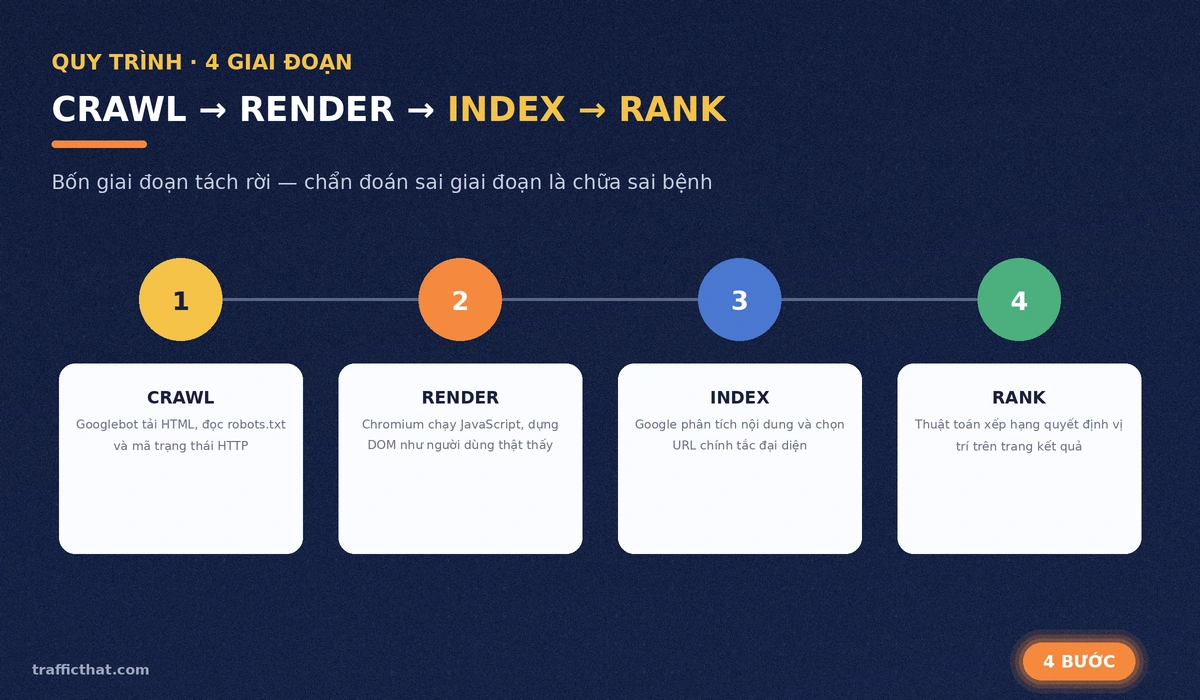
Quy trình 4 giai đoạn: Crawl → Render → Index → Rank
Đây là phần quan trọng nhất của bài. Hầu hết lỗi SEO kỹ thuật đều nằm ở chỗ người làm SEO gộp bốn giai đoạn này thành một, rồi chẩn đoán sai vấn đề. Hãy tách bạch từng bước.
Giai đoạn 1 — Crawling (Thu thập dữ liệu)
Googlebot lấy một URL ra khỏi crawl queue và gửi HTTP request. Ở bước này, chỉ ba yếu tố quyết định thành bại:
- Máy chủ có phản hồi không — nếu server trả 5xx hoặc timeout, Googlebot sẽ lùi lại và giảm tốc độ crawl toàn site.
- robots.txt có cho phép không — Googlebot luôn đọc file robots.txt trước khi crawl bất kỳ URL nào. Nếu bị chặn, nó dừng ngay và không tải HTML.
- Mã trạng thái HTTP là gì — 200 thì đi tiếp, 301 thì đi theo chuyển hướng, 404/410 thì loại khỏi index, 503 thì thử lại sau.
Sai lầm kinh điển: nhiều người chặn một trang trong robots.txt rồi ngạc nhiên khi thấy trang đó vẫn xuất hiện trên Google (chỉ có URL, không có mô tả). Lý do là robots.txt chặn crawl chứ không chặn index. Nếu có backlink trỏ tới URL đó, Google vẫn biết nó tồn tại và có thể đưa vào index dù chưa từng đọc nội dung. Muốn loại hẳn khỏi kết quả tìm kiếm, bạn phải dùng thẻ meta robots noindex và cho phép Googlebot crawl trang đó để nó đọc được thẻ này.
Giai đoạn 2 — Rendering (Kết xuất)
Sau khi tải HTML thô, Googlebot chuyển trang sang Web Rendering Service (WRS) — một trình duyệt Chromium không giao diện. WRS chạy JavaScript, tải CSS, dựng DOM cuối cùng giống hệt những gì người dùng thật nhìn thấy.
Vấn đề nằm ở chỗ: render tốn tài nguyên hơn crawl rất nhiều lần. Vì vậy Google đưa các trang cần render vào một hàng đợi riêng (render queue), và trang có thể nằm chờ ở đó từ vài giây đến vài ngày tùy mức độ ưu tiên. Đây là nguyên nhân trực tiếp của hiện tượng “bài đã được crawl nhưng nội dung Google thấy lại thiếu một nửa”.
Hệ quả thực tế cho website của bạn:
- Nội dung nằm trong HTML gốc (server-side rendering) được Google nhìn thấy ngay ở giai đoạn crawl.
- Nội dung chỉ xuất hiện sau khi JavaScript chạy (client-side rendering) phải chờ qua render queue — có thể chậm vài ngày.
- Nội dung chỉ hiện khi người dùng click, scroll hoặc hover thường không được Googlebot nhìn thấy vì nó không tương tác với trang.
- Nếu file JS/CSS bị chặn trong robots.txt, WRS không tải được và sẽ render ra một trang vỡ bố cục — Google đánh giá trang đó dựa trên bản vỡ đó.
Đây cũng là lý do các website dùng React, Vue hay Angular thuần client-side thường gặp khó khăn về index hơn hẳn website WordPress hoặc HTML tĩnh. Nếu bạn đang dùng framework JS, hãy ưu tiên SSR hoặc pre-render cho những trang cần SEO.
Giai đoạn 3 — Indexing (Lập chỉ mục)
Có nội dung đã render, Google mới bắt đầu phân tích: đọc thẻ heading, trích xuất văn bản, nhận diện chủ đề, phát hiện ngôn ngữ, và — bước then chốt — chọn URL đại diện (canonical) cho nhóm trang có nội dung giống nhau.
Google không tôn trọng tuyệt đối thẻ canonical bạn khai báo; nó coi đó là một gợi ý mạnh và đối chiếu thêm với sitemap, internal link, redirect và chất lượng nội dung. Nếu Google chọn URL khác với khai báo của bạn, Search Console sẽ báo “Trang thay thế có thẻ chính tắc phù hợp” — và trang gốc của bạn biến mất khỏi kết quả tìm kiếm.
Ở giai đoạn này, các lý do khiến trang bị loại khỏi index gồm: thẻ noindex, nội dung trùng lặp gần như hoàn toàn với trang khác, nội dung quá mỏng, trang lỗi mềm (soft 404), hoặc đơn giản là Google đánh giá trang không đủ giá trị để tốn dung lượng lưu trữ. Bạn có thể tra cứu chính xác từng lý do trong báo cáo lập chỉ mục của Search Console.
Giai đoạn 4 — Ranking (Xếp hạng)
Chỉ khi trang đã nằm trong index, nó mới đủ điều kiện tham gia cuộc đua xếp hạng. Giai đoạn này hoàn toàn không liên quan tới Googlebot nữa — nó thuộc về hệ thống truy vấn và hàng trăm tín hiệu xếp hạng chạy theo thời gian thực mỗi khi có người tìm kiếm.
Bài học chẩn đoán: nếu bạn tìm site:domain.com/duong-dan-bai-viet trên Google mà không thấy kết quả, vấn đề nằm ở giai đoạn 1-3 và bạn cần xử lý kỹ thuật. Nếu thấy kết quả nhưng thứ hạng thấp, vấn đề ở giai đoạn 4 và bạn cần xử lý nội dung, trải nghiệm và backlink. Đừng bao giờ tối ưu nội dung để chữa lỗi index — đó là chữa sai bệnh.
Googlebot tìm thấy URL mới bằng cách nào?
Googlebot không đoán URL. Nó chỉ biết những địa chỉ được ai đó chỉ cho nó. Có đúng năm con đường:
- Link nội bộ từ trang đã được index. Đây là kênh mạnh nhất và rẻ nhất. Khi Googlebot crawl lại một bài cũ đã index và thấy link mới trỏ tới bài mới, nó đưa URL đó vào hàng đợi gần như ngay lập tức. Đây chính là lý do một chiến lược internal link tốt quan trọng hơn nhiều so với việc chỉ nộp sitemap.
- Backlink từ website khác. Link từ một trang bên ngoài đã được index cũng đưa URL vào hàng đợi, thường kèm mức ưu tiên cao hơn nếu site đó có uy tín.
- Sitemap XML. Sitemap là danh sách URL bạn tự khai báo. Nó hữu ích nhưng bị đánh giá ưu tiên thấp hơn link thật — Google coi sitemap là “gợi ý”, còn link là “phiếu bầu”.
- RSS/Atom feed. Ít người tận dụng, nhưng Google đọc feed thường xuyên hơn sitemap.xml vì feed vốn được thiết kế cho nội dung mới. Nộp
/feed/như một sitemap trong Search Console là mẹo rẻ tiền mà hiệu quả. - Yêu cầu lập chỉ mục thủ công qua công cụ Kiểm tra URL trong Google Search Console. Hạn ngạch rất thấp (khoảng 10-12 URL/ngày) và có thể bị siết bất ngờ, nên đây là giải pháp bổ sung chứ không phải giải pháp chính.
Một website đăng 3 bài/ngày mà chỉ trông vào sitemap sẽ nhanh chóng rơi vào tình trạng tồn đọng: URL nằm trong sitemap hàng tuần mà vẫn ở trạng thái “Đã phát hiện – chưa index”. Cách chữa nhanh nhất không phải là nộp lại sitemap, mà là đi link ngược từ 2-3 bài cũ đã index về bài mới.
Crawl rate và crawl demand: Googlebot quyết định crawl bao nhiêu?
Googlebot không crawl vô hạn. Khối lượng nó dành cho website của bạn được quyết định bởi hai đại lượng nhân với nhau.
Crawl capacity limit — giới hạn máy chủ chịu được
Google không muốn làm sập website của bạn. Nó liên tục đo thời gian phản hồi và tỷ lệ lỗi của máy chủ để tự điều chỉnh tốc độ:
- Máy chủ phản hồi nhanh, ổn định (dưới 200ms, không lỗi) → Googlebot tăng dần số request song song.
- Thời gian phản hồi tăng lên hoặc xuất hiện lỗi 5xx → Googlebot giảm tốc độ ngay lập tức và giữ mức thấp trong nhiều ngày sau đó.
- Máy chủ trả 503 hoặc 429 liên tục → Googlebot có thể gần như ngừng crawl site trong một khoảng thời gian dài.
Đây là lý do hosting rẻ tiền là kẻ thù thầm lặng của SEO. Một website nội dung tốt nhưng đặt trên shared hosting quá tải sẽ bị Googlebot “hạ tốc” và bài mới mất hàng tuần mới được crawl, trong khi đối thủ trên VPS tốt được crawl trong vài giờ.
Crawl demand — nhu cầu crawl từ phía Google
Ngay cả khi máy chủ khỏe, Google vẫn chỉ crawl nhiều khi nó muốn. Nhu cầu này phụ thuộc:
- Độ phổ biến của URL — trang có nhiều link trỏ tới (cả nội bộ lẫn bên ngoài) được crawl thường xuyên hơn.
- Tần suất thay đổi nội dung — Google học được rằng trang nào thường xuyên cập nhật thì quay lại nhanh hơn. Một trang tĩnh không đổi suốt một năm có thể chỉ được crawl vài tháng một lần.
- Độ tươi mới của site — website đăng đều đặn tạo thói quen crawl đều đặn.
- Chất lượng tổng thể — nếu Google đã crawl 500 trang của bạn và phần lớn là nội dung mỏng hoặc trùng lặp, nó sẽ giảm nhu cầu crawl cho toàn bộ domain.
Tích của hai đại lượng này chính là khái niệm crawl budget. Với website dưới vài nghìn URL, crawl budget hiếm khi là nút thắt thật sự — nút thắt thường là crawl demand thấp vì thiếu link và thiếu tín hiệu tươi mới. Với website thương mại điện tử hàng trăm nghìn URL, crawl budget mới trở thành bài toán thực sự cần tối ưu.
Bảng đối chiếu: website được crawl tốt và website bị crawl kém
| Tín hiệu quan sát được | Website crawl tốt | Website crawl kém |
|---|---|---|
| Thời gian từ lúc đăng đến khi index | Vài giờ đến 2 ngày | 1-4 tuần hoặc không bao giờ |
| Thời gian phản hồi trung bình (GSC Crawl stats) | Dưới 300ms | Trên 800ms |
| Tỷ lệ phản hồi mã 200 | Trên 90% | Dưới 70%, nhiều 404/5xx |
| Số trang mồ côi (không có internal link trỏ tới) | Gần như bằng 0 | Chiếm 20-50% tổng số trang |
| Độ sâu click từ trang chủ | Tối đa 3 click | 5 click trở lên |
| Trạng thái phổ biến trong báo cáo index | “Đã lập chỉ mục” | “Đã phát hiện – chưa được lập chỉ mục” |
5 cách kiểm tra Googlebot có đang ghé website của bạn
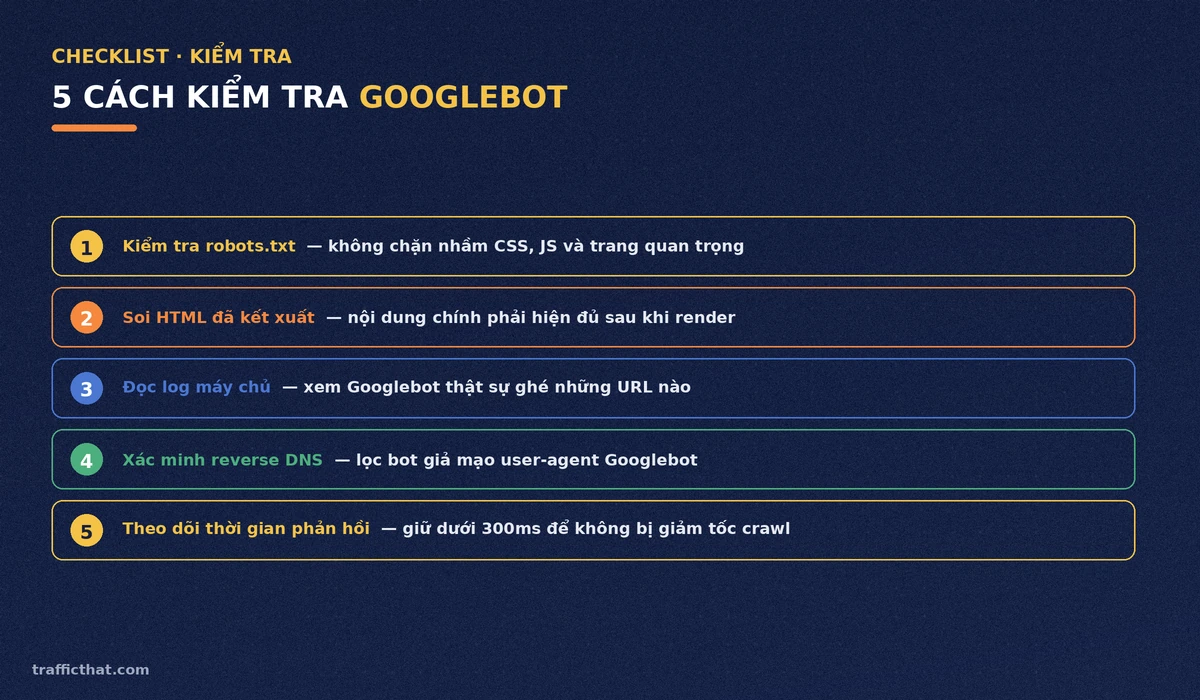
Đừng đoán. Có năm cách lấy dữ liệu thật, xếp theo thứ tự từ dễ tới chuyên sâu.
1. Báo cáo Thống kê thu thập dữ liệu trong Search Console
Vào Cài đặt → Thống kê thu thập dữ liệu. Đây là nguồn dữ liệu chính thức và miễn phí tốt nhất. Bạn cần đọc ba biểu đồ:
- Tổng số yêu cầu thu thập dữ liệu — xu hướng nên đi ngang hoặc tăng nhẹ. Nếu tụt dốc đột ngột, hãy kiểm tra ngay robots.txt và tình trạng máy chủ.
- Tổng dung lượng tải xuống — nếu dung lượng tăng vọt mà số request không tăng, có thể bạn vừa thêm ảnh hoặc file nặng làm hao crawl budget.
- Thời gian phản hồi trung bình — con số quan trọng nhất. Mọi mức trên 500ms đều đáng lo.
Bên dưới còn có phân tách theo mã phản hồi, theo loại tệp, theo mục đích (khám phá URL mới hay làm mới URL cũ) và theo loại Googlebot. Tỷ lệ “khám phá” quá thấp nghĩa là Google gần như không tìm thấy URL mới nào của bạn.
2. Công cụ Kiểm tra URL
Dán URL bất kỳ vào ô tìm kiếm trên cùng của Search Console. Bạn sẽ biết chính xác: URL có trong index không, lần crawl gần nhất là khi nào, Google chọn canonical là URL nào, và quan trọng nhất — bấm “Kiểm tra URL đang hoạt động” rồi xem tab HTML đã kết xuất để thấy đúng những gì Googlebot nhìn thấy sau khi render. Nếu HTML đó thiếu phần nội dung chính, bạn vừa tìm ra gốc rễ vấn đề.
3. Phân tích log máy chủ
Đây là nguồn sự thật tuyệt đối, vì log ghi lại từng request thật sự chạm vào máy chủ. Trên hosting Linux, bạn có thể lọc nhanh:
grep -i "googlebot" access.log | awk '{print $7}' | sort | uniq -c | sort -rn | head -30
Câu lệnh này cho bạn 30 URL được Googlebot ghé nhiều nhất. Kết quả thường gây bất ngờ: nhiều site phát hiện Googlebot đang tiêu tốn phần lớn tài nguyên vào các URL vô giá trị như trang lọc sản phẩm, trang tag rỗng, hoặc URL có tham số session. Với site lớn, nên dùng công cụ chuyên dụng như Screaming Frog Log File Analyser để đối chiếu danh sách URL được crawl với danh sách URL trong sitemap.
4. Xác minh Googlebot thật hay giả mạo
Bất kỳ ai cũng có thể giả user-agent Googlebot. Nhiều tool cào dữ liệu và bot xấu dùng chiêu này để vượt qua tường lửa. Cách xác minh chuẩn là reverse DNS lookup hai chiều:
- Lấy IP từ log, chạy
host 66.249.66.1— kết quả phải trả về tên miền kết thúc bằnggooglebot.comhoặcgoogle.com. - Chạy ngược lại
host crawl-66-249-66-1.googlebot.com— IP trả về phải khớp đúng IP ban đầu.
Chỉ khi cả hai chiều đều khớp thì đó mới là Googlebot thật. Nếu tên miền trả về thuộc một nhà cung cấp cloud bất kỳ, đó là bot giả mạo và bạn nên chặn nó ở tầng tường lửa. Đừng chặn theo dải IP cứng — Google thay đổi dải IP theo thời gian và công bố danh sách chính thức dưới dạng file JSON.
5. Kiểm tra nhanh bằng toán tử site:
Gõ site:domain.com để ước lượng số trang đang được index, hoặc site:domain.com/duong-dan để kiểm tra một URL cụ thể. Đây chỉ là phép đo thô, con số thường không chính xác tuyệt đối, nhưng đủ để phát hiện vấn đề lớn: nếu site có 300 bài mà toán tử chỉ trả về 40 kết quả, bạn đang có sự cố index nghiêm trọng.
9 nguyên nhân khiến Googlebot không crawl hoặc không index trang của bạn
Xếp theo tần suất gặp trong thực tế, từ phổ biến nhất:
- Trang mồ côi, không có internal link nào trỏ tới. Googlebot chỉ đi theo link. Trang chỉ nằm trong sitemap mà không được trang nào dẫn tới sẽ có mức ưu tiên rất thấp và có thể nằm chờ vô thời hạn.
- Website mới, chưa có độ tin cậy. Domain non trẻ được cấp crawl demand rất thấp. Đây là hiện tượng tự nhiên, không phải hình phạt, nhưng có thể kéo dài vài tháng nếu bạn không chủ động tạo tín hiệu.
- Máy chủ chậm hoặc hay lỗi. Như đã phân tích ở phần crawl capacity — server yếu trực tiếp bóp nghẹt tốc độ crawl.
- Bị chặn nhầm trong robots.txt. Đặc biệt hay xảy ra khi đẩy code từ môi trường staging lên production mà quên xóa dòng
Disallow: /. - Thẻ meta robots noindex sót lại. Plugin SEO, theme, hoặc cài đặt “Ngăn công cụ tìm kiếm lập chỉ mục trang web này” trong WordPress đều có thể âm thầm thêm thẻ này.
- Nội dung mỏng hoặc trùng lặp. Google crawl rồi quyết định không lưu vào index. Trường hợp này Search Console báo “Đã thu thập dữ liệu – hiện chưa được lập chỉ mục” — khác hẳn với “Đã phát hiện”.
- Canonical trỏ sang URL khác. Trang bị gộp vào một URL đại diện khác và biến mất khỏi kết quả.
- Nội dung phụ thuộc hoàn toàn vào JavaScript. Trang được crawl nhưng render ra gần như rỗng.
- Chuỗi redirect dài hoặc vòng lặp redirect. Googlebot chỉ đi theo một số bước chuyển hướng nhất định rồi bỏ cuộc.
Cách phân biệt nhanh hai trạng thái hay bị nhầm lẫn nhất: “Đã phát hiện – chưa index” nghĩa là Google biết URL nhưng chưa bao giờ tải về — đây là bài toán crawl, chữa bằng link và tốc độ máy chủ. “Đã thu thập – chưa index” nghĩa là Google đã đọc nhưng quyết định không lưu — đây là bài toán chất lượng nội dung, chữa bằng cách viết sâu hơn và khác biệt hơn.
12 cách tối ưu website cho Googlebot
Danh sách này xếp theo tỷ lệ hiệu quả trên công sức bỏ ra:
- Xây link nội bộ từ bài cũ đã index về bài mới. Mỗi bài mới nên nhận ít nhất 2-3 link từ các bài cũ cùng chủ đề. Đây là đòn bẩy mạnh nhất và gần như miễn phí.
- Giữ độ sâu click tối đa 3 cấp tính từ trang chủ. Trang nằm sâu 5-6 click gần như không bao giờ được crawl thường xuyên.
- Đảm bảo trang chủ có khối “Bài viết mới nhất” được render sẵn từ máy chủ — không phải nạp bằng JavaScript sau khi tải trang.
- Cải thiện thời gian phản hồi máy chủ (TTFB) xuống dưới 300ms bằng cache, CDN và nâng cấp hosting.
- Dọn sạch lỗi 404 và chuỗi redirect trong sitemap và internal link. Mỗi URL lỗi là một lần crawl bị lãng phí.
- Nộp thêm RSS feed như một sitemap trong Search Console — Google đọc feed thường xuyên hơn sitemap.xml.
- Cho phép Googlebot tải file CSS và JavaScript. Kiểm tra lại robots.txt, đừng chặn thư mục
/wp-includes/hay/assets/. - Đưa nội dung quan trọng vào HTML gốc, không phụ thuộc JS để hiển thị.
- Dùng thẻ canonical nhất quán trên toàn site, tránh việc mỗi trang khai báo một kiểu.
- Cập nhật bài cũ định kỳ — nội dung thay đổi làm tăng crawl demand cho cả cụm chủ đề.
- Chặn crawl các URL vô giá trị như trang lọc, trang sắp xếp, URL có tham số session để dồn tài nguyên cho trang quan trọng.
- Tạo tín hiệu truy cập thật ổn định. Trang có người dùng thật ghé thường xuyên thường được Googlebot quay lại nhanh hơn — đây là mối quan hệ đã được quan sát rõ giữa traffic thật và tốc độ index.
7 sai lầm thường gặp khi làm việc với Googlebot
Đây là những lỗi đã khiến nhiều website mất traffic thật, không phải lý thuyết:
- Dùng robots.txt để ẩn trang khỏi kết quả tìm kiếm. Như đã phân tích, robots.txt chặn crawl chứ không chặn index. Muốn ẩn hẳn, phải dùng noindex và để Googlebot vào đọc được thẻ đó. Chặn robots.txt kèm noindex là tự vô hiệu hóa noindex.
- Chặn Googlebot bằng tường lửa hoặc Cloudflare mà không biết. Nhiều cấu hình bảo mật hung hãn chặn luôn dải IP của Google. Triệu chứng: Search Console báo lỗi máy chủ dù website mở bình thường trên trình duyệt.
- Bấm “Yêu cầu lập chỉ mục” liên tục cho cùng một URL. Việc này không làm Google index nhanh hơn, và bấm dồn dập có thể khiến cả property bị siết hạn ngạch. Thay vào đó hãy đi link nội bộ.
- Nộp sitemap chứa URL 404, URL redirect hoặc URL noindex. Sitemap bẩn làm giảm độ tin cậy của toàn bộ sitemap trong mắt Google.
- Tin rằng sitemap là đủ để được index. Sitemap chỉ là lời khai báo. Không có link thật trỏ tới, URL vẫn nằm im trong hàng đợi.
- Nhầm lẫn giữa crawl và index khi chẩn đoán. Hai trạng thái này cần hai cách chữa hoàn toàn khác nhau; chữa nhầm sẽ mất hàng tuần mà không cải thiện gì.
- Chặn nhầm Google-InspectionTool hoặc Googlebot Image. Lỗi này không làm tụt hạng ngay nên rất khó phát hiện, nhưng âm thầm cắt mất một kênh traffic hoặc làm hỏng công cụ chẩn đoán của chính bạn.
Lộ trình 30 ngày cải thiện tốc độ crawl và index
Áp dụng được cho cả website mới lẫn website đang bị tồn đọng index.
Tuần 1 — Chẩn đoán và dọn dẹp kỹ thuật
- Mở Thống kê thu thập dữ liệu, ghi lại ba con số nền: tổng request/ngày, thời gian phản hồi trung bình, tỷ lệ mã 200.
- Kiểm tra robots.txt từng dòng. Xác nhận CSS và JS không bị chặn.
- Crawl toàn site bằng Screaming Frog, xuất danh sách URL trả 404, chuỗi redirect và trang mồ côi.
- Kiểm tra thẻ meta robots trên 10 trang quan trọng nhất, đảm bảo không có noindex sót lại.
- Đối chiếu sitemap với kết quả crawl, loại bỏ mọi URL không trả 200.
Tuần 2 — Sửa gốc rễ
- Xử lý toàn bộ 404 và redirect tìm được ở tuần 1.
- Bật cache toàn trang, cân nhắc CDN nếu TTFB trên 500ms.
- Thêm link nội bộ cho mọi trang mồ côi — mỗi trang ít nhất 2 link trỏ tới.
- Rút ngắn độ sâu click cho các trang quan trọng về tối đa 3 cấp.
- Nộp
/feed/làm sitemap bổ sung trong Search Console.
Tuần 3 — Tạo tín hiệu tươi mới
- Cập nhật 5-10 bài cũ có tiềm năng nhất: bổ sung nội dung thật, thêm dữ liệu mới.
- Trong mỗi bài cập nhật, chèn 1-2 link contextual về các bài mới cần index.
- Đảm bảo trang chủ hiển thị bài mới nhất bằng HTML render sẵn từ máy chủ.
- Xây 2-3 backlink chất lượng trỏ về các trang chủ đề quan trọng.
Tuần 4 — Đo lại và điều chỉnh
- So sánh ba con số nền của tuần 1 với hiện tại. Kỳ vọng hợp lý: thời gian phản hồi giảm rõ rệt, số request tăng 20-50%.
- Kiểm tra báo cáo lập chỉ mục: số trang ở trạng thái “Đã phát hiện – chưa index” phải giảm.
- Đo lại thời gian trung bình từ lúc đăng bài tới lúc được index.
- Lặp lại chu kỳ với nhóm trang tiếp theo.
Lưu ý về kỳ vọng: crawl budget và crawl demand thay đổi chậm. Đừng đánh giá kết quả sau 3 ngày. Mốc đo hợp lý là 3-4 tuần, và với domain mới có thể cần 2-3 tháng để Google hình thành thói quen crawl ổn định.
Checklist kiểm tra nhanh Googlebot
In ra và chạy qua mỗi tháng một lần:
- robots.txt không chặn nhầm trang quan trọng, CSS, JS.
- Không có thẻ noindex ngoài ý muốn trên các trang cần xếp hạng.
- Sitemap chỉ chứa URL trả mã 200, đã được cập nhật tự động.
- Thời gian phản hồi máy chủ trung bình dưới 300ms.
- Không có trang mồ côi trong kết quả crawl bằng Screaming Frog.
- Độ sâu click tối đa 3 cấp cho trang quan trọng.
- Bài mới nhất nhận được ít nhất 2 link nội bộ từ bài cũ đã index.
- HTML đã kết xuất trong công cụ Kiểm tra URL chứa đầy đủ nội dung chính.
- Không có URL rác (tham số lọc, session) chiếm phần lớn log crawl.
- Canonical trên mọi trang trỏ đúng về chính nó hoặc URL đại diện hợp lý.
Câu hỏi thường gặp về Googlebot
Googlebot ghé website của tôi bao lâu một lần?
Không có con số cố định. Website tin tức lớn có thể được crawl vài phút một lần, blog cá nhân mới có thể vài tuần một lần. Cách duy nhất để biết chính xác là xem Thống kê thu thập dữ liệu trong Search Console hoặc đọc log máy chủ. Nếu muốn tăng tần suất, hãy tập trung vào ba yếu tố: tốc độ máy chủ, số link trỏ tới trang, và mức độ thường xuyên cập nhật nội dung.
Làm sao biết Googlebot đang gặp lỗi trên website của tôi?
Mở Search Console → Cài đặt → Thống kê thu thập dữ liệu → phần “Theo phản hồi”. Nếu tỷ lệ mã 5xx hoặc 404 vượt quá 10%, bạn đang có vấn đề. Bấm vào từng nhóm mã để xem danh sách URL cụ thể rồi xử lý theo thứ tự ưu tiên: sửa 5xx trước vì nó ảnh hưởng tới tốc độ crawl toàn site, sau đó tới 404.
Chặn Googlebot trong robots.txt có làm trang biến mất khỏi Google không?
Không hẳn. Robots.txt chặn Googlebot tải nội dung, nhưng nếu có link từ nơi khác trỏ tới, Google vẫn biết URL đó tồn tại và có thể hiển thị URL trần trong kết quả tìm kiếm mà không có mô tả. Muốn loại hoàn toàn, hãy dùng thẻ meta robots noindex và cho phép Googlebot crawl trang đó để nó đọc được thẻ.
Googlebot có đọc được JavaScript không?
Có, nhưng theo hai giai đoạn tách rời. Googlebot crawl HTML trước, sau đó mới đưa trang vào hàng đợi render để chạy JavaScript. Độ trễ giữa hai bước có thể từ vài giây đến vài ngày. Vì vậy nội dung quan trọng nên nằm sẵn trong HTML gốc; nội dung chỉ xuất hiện sau khi người dùng click hoặc scroll thì Googlebot thường không nhìn thấy.
Có cách nào ép Googlebot crawl ngay lập tức không?
Không có cách nào ép tuyệt đối. Công cụ Kiểm tra URL với nút “Yêu cầu lập chỉ mục” là cách nhanh nhất nhưng hạn ngạch rất thấp và thường xuyên bị siết. Cách bền vững hơn là tạo link nội bộ từ các trang đã được index về trang mới — đây là kênh mà Google luôn ưu tiên và không có giới hạn hạn ngạch.
Bot giả mạo Googlebot có hại không và xử lý thế nào?
Có. Bot giả thường cào nội dung hoặc dò lỗ hổng, đồng thời làm tăng tải máy chủ khiến Googlebot thật bị giảm tốc độ crawl. Cách xử lý: xác minh bằng reverse DNS hai chiều như hướng dẫn ở trên, rồi chặn các IP không vượt qua kiểm tra ở tầng tường lửa hoặc CDN. Tuyệt đối không chặn theo dải IP cứng vì Google thay đổi dải IP định kỳ.
Hiểu cách Googlebot vận hành mới là bước đầu; để biến hiểu biết đó thành quy trình lặp lại được cho mỗi bài mới, hãy tham khảo thêm cách index bài viết nhanh với lộ trình 72 giờ cụ thể.
Với các website dựng bằng React hay Vue, quá trình crawl và render còn phức tạp hơn một bậc — bạn có thể xem thêm cách xử lý trong bài JavaScript SEO để đảm bảo Googlebot đọc được đầy đủ nội dung ngay từ HTML gốc.
Kết luận
Googlebot là cánh cửa đầu tiên và bắt buộc phải qua của mọi chiến lược SEO. Nội dung xuất sắc đến đâu, backlink mạnh đến đâu cũng vô nghĩa nếu con bot này không crawl được trang của bạn. Điều đáng mừng là phần lớn vấn đề về crawl và index đều có nguyên nhân kỹ thuật rõ ràng và cách chữa cụ thể — khác hẳn với bài toán xếp hạng vốn mơ hồ hơn nhiều.
Ba việc cần làm ngay trong 48 giờ tới:
- Mở Thống kê thu thập dữ liệu trong Search Console và ghi lại thời gian phản hồi trung bình cùng tỷ lệ mã 200. Đây là đường cơ sở để đo mọi cải thiện sau này.
- Kiểm tra robots.txt và thẻ meta robots trên 10 trang quan trọng nhất. Riêng bước này đã cứu được rất nhiều website khỏi tình trạng không index kéo dài hàng tháng mà không ai biết lý do.
- Chọn 3 bài mới nhất chưa được index và đi link nội bộ về chúng từ các bài cũ cùng chủ đề đã nằm trong index. Đây là hành động rẻ nhất, nhanh nhất và hiệu quả nhất trong toàn bộ danh sách.
Làm chủ được Googlebot không đòi hỏi kiến thức lập trình sâu — chỉ cần bạn ngừng đoán và bắt đầu đọc dữ liệu thật từ Search Console và log máy chủ. Khi tốc độ crawl ổn định, mọi nỗ lực nội dung phía sau mới bắt đầu sinh lãi.


 Zalo