
Chỉ một dòng lệnh sai trong file robots.txt cũng đủ khiến toàn bộ website biến mất khỏi Google trong vài tuần. Ngược lại, một file robots.txt được tối ưu đúng sẽ giúp Googlebot dồn sức thu thập những trang thực sự mang lại traffic, thay vì lãng phí vào hàng nghìn URL rác. Bài viết này giải thích robots.txt là gì, cách tạo, cách tối ưu và những lỗi phổ biến nhất khiến website mất thứ hạng.
Robots.txt là gì?
Robots.txt là gì? Đó là một file văn bản thuần (plain text) đặt tại thư mục gốc của tên miền, dùng để hướng dẫn các con bot của công cụ tìm kiếm được phép hoặc không được phép thu thập dữ liệu (crawl) ở những đường dẫn nào trên website. File này tuân theo chuẩn Robots Exclusion Protocol — một giao thức đã tồn tại từ những năm 1990 và được Google chính thức hóa thành RFC 9309 vào năm 2022.
Địa chỉ của file luôn cố định theo công thức: tên-miền.com/robots.txt. Bạn có thể kiểm tra file robots.txt của bất kỳ website nào bằng cách gõ trực tiếp đường dẫn này lên trình duyệt. Nếu website chưa có file, máy chủ sẽ trả về lỗi 404 — và trong trường hợp đó, các bot mặc định hiểu rằng chúng được phép thu thập toàn bộ website.
Điểm quan trọng nhất cần nhớ ngay từ đầu: robots.txt là một lời đề nghị, không phải một hàng rào bảo mật. Các bot uy tín như Googlebot, Bingbot đều tôn trọng file này, nhưng bot xấu và công cụ cào dữ liệu hoàn toàn có thể phớt lờ nó. Vì vậy, đừng bao giờ dùng robots.txt để giấu thông tin nhạy cảm — ngược lại, việc liệt kê một thư mục vào Disallow còn vô tình chỉ điểm cho kẻ xấu biết thư mục đó tồn tại.
Robots.txt hoạt động như thế nào?
Khi Googlebot chuẩn bị thu thập một website, việc đầu tiên nó làm không phải là tải trang chủ, mà là tải file robots.txt. Quy trình diễn ra theo bốn bước:
- Bot yêu cầu file robots.txt tại thư mục gốc của tên miền.
- Bot đọc và phân tích các quy tắc, tìm nhóm quy tắc khớp với tên user-agent của chính nó.
- Bot lọc danh sách URL định thu thập, loại bỏ những URL rơi vào quy tắc Disallow.
- Bot tiến hành thu thập phần còn lại và lưu bản ghi robots.txt vào bộ nhớ đệm khoảng 24 giờ.
Chi tiết cuối cùng rất đáng lưu ý: vì Google cache file robots.txt tới 24 giờ, mọi thay đổi bạn thực hiện sẽ không có hiệu lực ngay lập tức. Nếu bạn vừa gỡ nhầm một dòng Disallow, đừng hoảng khi thấy Google vẫn chưa quay lại thu thập — hãy đợi ít nhất một ngày rồi mới đánh giá.
Cấu trúc và cú pháp file robots.txt
File robots.txt được tạo thành từ các nhóm quy tắc. Mỗi nhóm bắt đầu bằng một dòng User-agent, theo sau là các dòng Disallow hoặc Allow áp dụng cho bot đó.
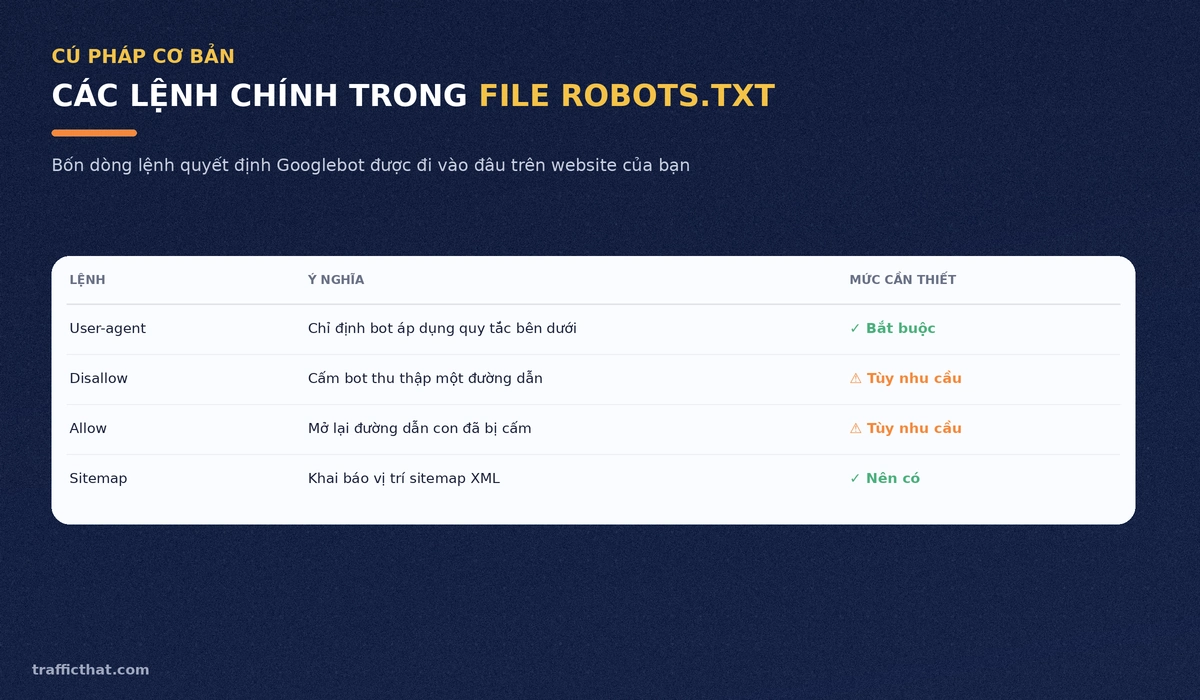
User-agent
Xác định quy tắc bên dưới áp dụng cho bot nào. Dấu hoa thị (*) nghĩa là áp dụng cho mọi bot. Một số user-agent thường gặp: Googlebot (tìm kiếm Google), Googlebot-Image (ảnh), Bingbot, GPTBot (thu thập dữ liệu huấn luyện AI của OpenAI).
Disallow
Cấm bot thu thập đường dẫn chỉ định. Dòng Disallow: / chặn toàn bộ website — đây chính là dòng lệnh nguy hiểm nhất trong SEO. Dòng Disallow: để trống thì ngược lại, cho phép thu thập tất cả.
Allow
Mở lại một đường dẫn con nằm trong thư mục đã bị Disallow. Khi hai quy tắc xung đột, Google áp dụng nguyên tắc quy tắc nào cụ thể hơn (dài hơn) sẽ thắng, chứ không phải quy tắc nào viết trước.
Sitemap
Khai báo đường dẫn tuyệt đối tới sitemap XML. Dòng này độc lập với các nhóm user-agent và có thể đặt ở bất kỳ đâu trong file. Nếu bạn chưa nắm rõ vai trò của sitemap, hãy đọc thêm bài sitemap là gì và cách submit sitemap XML lên Google để hiểu cách hai file này bổ trợ nhau.
Ký tự đại diện
Google hỗ trợ hai ký tự đặc biệt: dấu * thay cho chuỗi ký tự bất kỳ, và dấu $ đánh dấu kết thúc URL. Ví dụ, Disallow: /*.pdf$ sẽ chặn mọi file PDF trên website.
Phân biệt robots.txt với thẻ meta robots
Đây là điểm gây nhầm lẫn nhiều nhất và cũng là nguyên nhân của vô số lỗi SEO nghiêm trọng. Hai công cụ này giải quyết hai vấn đề hoàn toàn khác nhau.

Robots.txt chặn việc THU THẬP. Bot không được phép tải nội dung trang. Nhưng nếu trang đó có backlink trỏ tới từ nơi khác, Google vẫn có thể lập chỉ mục URL đó và hiển thị nó trong kết quả tìm kiếm — chỉ khác là phần mô tả sẽ trống hoặc ghi “Không có thông tin cho trang này”.
Thẻ meta robots noindex chặn việc LẬP CHỈ MỤC. Bot vẫn tải trang, đọc thấy chỉ thị noindex và loại trang khỏi kết quả tìm kiếm.
Hệ quả thực tế cực kỳ quan trọng: nếu bạn muốn gỡ một URL khỏi Google, tuyệt đối đừng chặn nó bằng robots.txt. Khi bị chặn thu thập, bot không thể tải trang, do đó không bao giờ đọc được thẻ noindex bạn vừa gắn — URL sẽ nằm lì trong kết quả tìm kiếm. Cách làm đúng là để trang mở cho bot thu thập, gắn noindex, đợi Google xử lý xong rồi mới cân nhắc chặn bằng robots.txt.
Cách tạo file robots.txt cho WordPress
WordPress mặc định tạo ra một file robots.txt ảo, tồn tại trong bộ nhớ chứ không nằm thật trên máy chủ. File ảo này rất tối giản và bạn không sửa trực tiếp được. Có ba cách để kiểm soát nó:
- Dùng plugin SEO: hầu hết plugin SEO phổ biến đều có mục chỉnh sửa robots.txt ngay trong giao diện quản trị. Đây là cách nhanh và an toàn nhất cho người mới.
- Tạo file thật qua FTP hoặc File Manager: soạn một file văn bản đặt tên robots.txt rồi tải lên thư mục gốc (thường là public_html). File thật luôn được ưu tiên hơn file ảo của WordPress.
- Can thiệp bằng code: dùng hook robots_txt trong file functions.php của theme. Cách này chỉ nên dùng khi bạn đã quen với việc chỉnh sửa mã nguồn.
Mẫu robots.txt chuẩn cho WordPress 2026
Dưới đây là cấu hình an toàn, phù hợp với đa số website WordPress làm nội dung và bán hàng:
User-agent: *
Allow: /wp-admin/admin-ajax.php
Disallow: /wp-admin/
Disallow: /wp-login.php
Disallow: /?s=
Disallow: /search/
Disallow: /*?replytocom=
Disallow: /cart/
Disallow: /checkout/
Disallow: /my-account/

Sitemap: https://ten-mien-cua-ban.com/sitemap_index.xml
Giải thích nhanh vì sao chặn từng mục: /wp-admin/ là khu quản trị không có giá trị tìm kiếm, nhưng phải chừa lại admin-ajax.php vì nhiều theme dùng file này để tải nội dung động — chặn nhầm sẽ khiến Google thấy trang vỡ giao diện. Các URL tìm kiếm nội bộ dạng /?s= sinh ra vô hạn trang mỏng, dễ dẫn tới tình trạng ăn thịt từ khóa giữa các trang. Các trang giỏ hàng và thanh toán mang tính cá nhân, không cần xuất hiện trên Google.
Lưu ý một điểm nhiều người làm sai: đừng chặn thư mục /wp-content/uploads/. Đây là nơi chứa toàn bộ hình ảnh, và chặn nó đồng nghĩa với việc bạn tự loại mình khỏi Google Image Search — một nguồn traffic miễn phí đáng kể nếu bạn đã tối ưu hình ảnh chuẩn SEO. Tương tự, đừng chặn file CSS và JavaScript, vì Google cần chúng để render trang và đánh giá trải nghiệm trên di động theo cơ chế Mobile-First Indexing.
Robots.txt và ngân sách thu thập dữ liệu
Với website nhỏ dưới vài trăm URL, robots.txt gần như không ảnh hưởng tới tốc độ index. Nhưng khi website vượt mốc vài nghìn URL, câu chuyện đổi hẳn: Googlebot chỉ dành một lượng tài nguyên hữu hạn cho mỗi tên miền mỗi ngày. Nếu lượng tài nguyên đó bị đốt vào các URL lọc sản phẩm, URL phân trang vô tận hay tham số theo dõi, những bài viết mới quan trọng sẽ phải xếp hàng rất lâu mới tới lượt.
Đây chính là lúc robots.txt phát huy giá trị lớn nhất — nó là công cụ trực tiếp nhất để điều tiết ngân sách thu thập dữ liệu của Googlebot. Bằng cách chặn các nhóm URL không có giá trị tìm kiếm, bạn dồn toàn bộ tài nguyên thu thập vào những trang thực sự tạo ra doanh thu.
Một yếu tố nữa thường bị bỏ qua: tần suất Googlebot quay lại phụ thuộc không nhỏ vào tín hiệu người dùng thật trên trang. Website có lượt truy cập đều đặn thường được thu thập lại nhanh hơn — mối liên hệ này được phân tích chi tiết trong bài mối quan hệ giữa traffic user và tốc độ index bài viết mới.
7 lỗi robots.txt thường gặp khiến mất traffic
| Lỗi | Hậu quả | Cách xử lý |
|---|---|---|
| Để nguyên Disallow: / sau khi lên production | Toàn bộ website biến mất khỏi Google | Kiểm tra ngay sau mỗi lần deploy |
| Chặn thư mục chứa CSS và JS | Google render sai trang, tụt điểm trải nghiệm | Bỏ dòng Disallow với tài nguyên hiển thị |
| Dùng robots.txt để gỡ URL đã index | URL vẫn nằm trong kết quả tìm kiếm | Dùng thẻ noindex, mở cho bot thu thập |
| Đặt file sai vị trí, không ở thư mục gốc | File bị bỏ qua hoàn toàn | Đảm bảo truy cập được tại /robots.txt |
| Viết sai chính tả tên lệnh | Dòng lệnh bị bỏ qua âm thầm | Kiểm tra bằng công cụ test của Google |
| Chặn URL nhưng vẫn khai báo trong sitemap | Tín hiệu mâu thuẫn, báo lỗi trong Search Console | Đồng bộ sitemap với robots.txt |
| Quên khai báo dòng Sitemap | Bot mất thêm thời gian tìm URL mới | Thêm đường dẫn sitemap tuyệt đối |
Trong số này, lỗi để sót Disallow: / từ môi trường thử nghiệm là nghiêm trọng nhất và cũng phổ biến một cách đáng ngạc nhiên. Nhiều đội phát triển chặn toàn bộ website trên bản staging để tránh trùng lặp nội dung, rồi khi đẩy lên bản chính thức lại quên gỡ dòng lệnh đó. Hậu quả thường chỉ bị phát hiện sau vài tuần, khi traffic đã rơi thẳng đứng và hàng loạt URL bị loại khỏi chỉ mục.
Cách kiểm tra và test file robots.txt
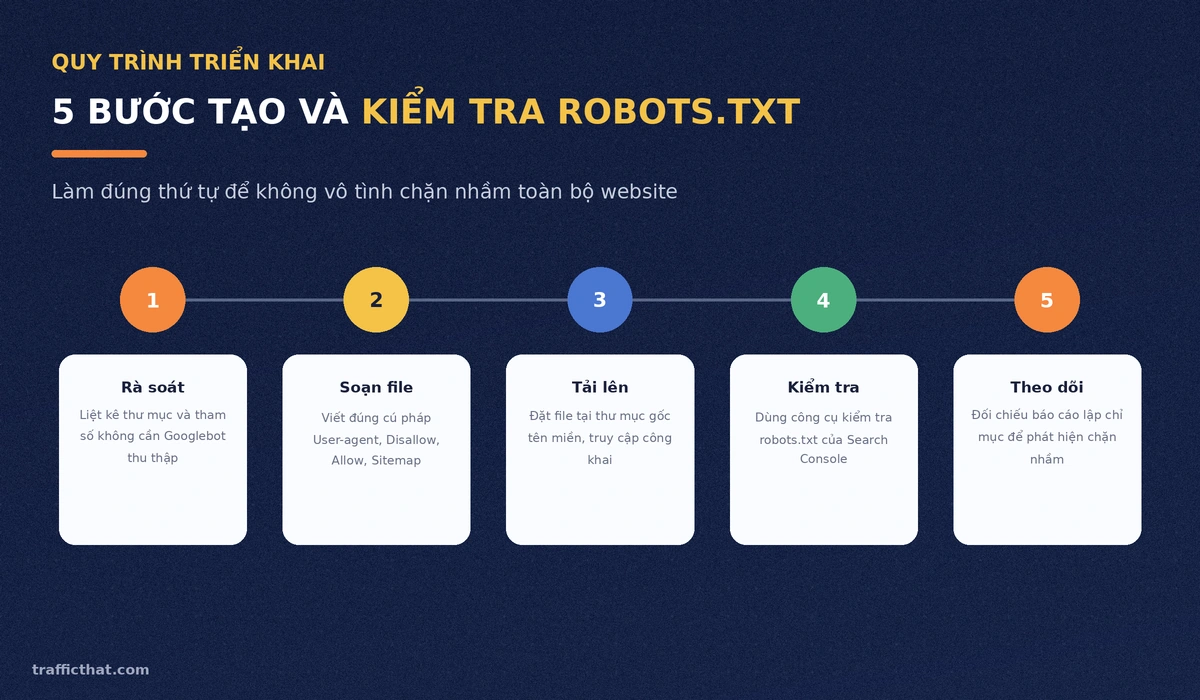
Đừng bao giờ chỉnh sửa robots.txt rồi bỏ đó. Sau mỗi thay đổi, hãy chạy đủ ba lớp kiểm tra:
- Kiểm tra thủ công: mở trực tiếp tên-miền.com/robots.txt trên trình duyệt, xác nhận file trả về mã 200 và nội dung đúng như bạn vừa lưu.
- Dùng công cụ của Google: báo cáo robots.txt trong Google Search Console cho biết Google đọc được phiên bản nào, đọc lúc nào và có gặp lỗi cú pháp không.
- Kiểm tra URL cụ thể: dùng công cụ Kiểm tra URL để xem một đường dẫn quan trọng có đang bị chặn ngoài ý muốn hay không.
Sau đó, theo dõi báo cáo lập chỉ mục trong vài tuần kế tiếp. Nếu thấy số lượng URL ở trạng thái “Đã lập chỉ mục nhưng bị robots.txt chặn” tăng bất thường, đó là dấu hiệu cấu hình đang có mâu thuẫn — bài khắc phục lỗi trang chưa được lập chỉ mục hướng dẫn cách đọc và xử lý từng loại trạng thái này.
Cuối cùng, hãy xem robots.txt như một phần của bộ khung kỹ thuật tổng thể chứ không phải một file riêng lẻ. Nó phối hợp cùng sitemap, thẻ canonical, thẻ meta robots và cấu trúc liên kết nội bộ để tạo nên một website dễ thu thập. Nếu bạn đang xây dựng nền tảng kỹ thuật từ đầu, checklist trong bài SEO Onpage là gì và checklist tối ưu onpage sẽ giúp bạn không bỏ sót hạng mục nào.
Câu hỏi thường gặp về robots.txt
Website không có file robots.txt có sao không?
Không sao cả. Khi không tìm thấy file, các bot mặc định được phép thu thập toàn bộ website. Với website nhỏ, đơn giản, đây thậm chí là lựa chọn an toàn hơn là tạo một file cấu hình sai. Tuy nhiên, bạn vẫn nên có file để khai báo sitemap và chặn các khu vực quản trị.
Robots.txt có chặn được website khỏi Google hoàn toàn không?
Không hoàn toàn. Dòng Disallow: / ngăn bot tải nội dung, nhưng URL vẫn có thể xuất hiện trong kết quả tìm kiếm nếu có website khác trỏ link tới. Muốn ẩn hoàn toàn, bạn cần dùng thẻ meta noindex hoặc đặt mật khẩu bảo vệ ở cấp máy chủ.
Sau khi sửa robots.txt bao lâu thì Google cập nhật?
Google lưu bộ nhớ đệm file robots.txt khoảng 24 giờ. Trong trường hợp khẩn cấp — chẳng hạn vừa gỡ nhầm dòng chặn toàn site — bạn có thể yêu cầu Google đọc lại ngay thông qua báo cáo robots.txt trong Search Console.
Có nên chặn bot AI như GPTBot trong robots.txt không?
Đây là quyết định kinh doanh chứ không phải quyết định SEO. Chặn bot AI không ảnh hưởng gì tới thứ hạng trên Google Search, vì đó là các user-agent hoàn toàn khác nhau. Nếu bạn muốn nội dung không bị dùng làm dữ liệu huấn luyện, hãy thêm nhóm quy tắc riêng cho từng bot AI. Đổi lại, bạn có thể mất cơ hội được trích dẫn trong các câu trả lời của công cụ AI.
Robots.txt có phân biệt chữ hoa chữ thường không?
Phần đường dẫn có phân biệt. Disallow: /Tin-Tuc/ và Disallow: /tin-tuc/ là hai quy tắc khác nhau. Riêng tên lệnh (User-agent, Disallow) thì không phân biệt hoa thường, nhưng bạn vẫn nên viết đúng quy ước để dễ đọc và dễ bảo trì.
Cần nhớ robots.txt chỉ chặn bot tải trang chứ không gỡ trang khỏi chỉ mục. Muốn một URL chắc chắn biến mất khỏi kết quả tìm kiếm, bạn phải dùng thẻ meta robots với directive noindex, và tuyệt đối không Disallow URL đó trong robots.txt vì bot sẽ không bao giờ đọc được chỉ thị noindex.
Lưu ý rằng robots.txt chỉ là một trong nhiều yếu tố tác động tới quá trình thu thập dữ liệu — hãy xem thêm Googlebot là gì để hiểu con bot này quyết định crawl trang nào dựa trên tín hiệu gì.
Kết luận
Robots.txt là file nhỏ nhất nhưng có sức ảnh hưởng lớn nhất trong bộ công cụ SEO kỹ thuật. Nó không giúp bạn tăng thứ hạng một cách trực tiếp, nhưng một cấu hình sai có thể xóa sổ toàn bộ thành quả SEO chỉ sau vài tuần. Nguyên tắc an toàn: chặn càng ít càng tốt, chỉ chặn những gì bạn chắc chắn không có giá trị tìm kiếm, luôn khai báo sitemap, và kiểm tra lại bằng Search Console sau mỗi lần chỉnh sửa.
Khi nền tảng kỹ thuật đã sạch, bước tiếp theo là đưa tín hiệu người dùng thật vào website để Google có cơ sở đánh giá chất lượng nội dung. Đó là lúc việc kết hợp giữa tối ưu kỹ thuật và nguồn traffic chất lượng phát huy hiệu quả rõ rệt nhất.


 Zalo