
Bạn viết một bài chuẩn SEO, cấu trúc đẹp, tốc độ tốt, nhưng nó không bao giờ xuất hiện trên Google. Hoặc ngược lại: trang giỏ hàng, trang kết quả lọc sản phẩm, trang cảm ơn sau khi đặt hàng lại nằm chình ình trên SERP và làm loãng toàn bộ chủ đề website. Cả hai tình huống này thường có chung một nguyên nhân — thẻ meta robots bị cấu hình sai.
Đây là một trong những thẻ có sức phá hoại lớn nhất trong technical SEO: chỉ một dòng HTML đặt nhầm chỗ đủ để xoá sạch hàng nghìn trang khỏi chỉ mục Google. Nhưng cũng chính nó là công cụ chính xác nhất để bạn quyết định trang nào được lên SERP, trang nào không. Bài viết này giải thích đầy đủ thẻ meta robots là gì, từng giá trị directive có tác dụng gì, khác biệt với robots.txt ra sao, và cách triển khai an toàn trên WordPress.
Thẻ meta robots là gì?
Thẻ meta robots là một thẻ HTML đặt trong phần <head> của từng trang, dùng để ra chỉ thị cho công cụ tìm kiếm về cách xử lý trang đó: có được lập chỉ mục hay không, có được đi theo các liên kết trên trang hay không, có được hiển thị đoạn mô tả và bản lưu trong bộ nhớ đệm hay không.
Cú pháp cơ bản:
<meta name="robots" content="index, follow">— cho phép lập chỉ mục và đi theo link (đây là hành vi mặc định, không cần khai báo).<meta name="robots" content="noindex, follow">— không lập chỉ mục trang này, nhưng vẫn đi theo các liên kết trên đó.<meta name="robots" content="noindex, nofollow">— không lập chỉ mục và không đi theo liên kết nào.
Thuộc tính name có thể thay bằng tên bot cụ thể để ra chỉ thị riêng: name="googlebot" chỉ áp cho Googlebot, name="bingbot" chỉ áp cho Bing. Khi có cả thẻ chung robots lẫn thẻ riêng cho một bot, bot đó sẽ ưu tiên chỉ thị dành riêng cho mình.
Điểm quan trọng cần nhớ ngay: thẻ meta robots chỉ có hiệu lực khi bot tải được trang. Đây chính là nguồn gốc của lỗi cấu hình phổ biến nhất mà chúng ta sẽ phân tích ở phần tiếp theo.
Phân biệt thẻ meta robots và robots.txt
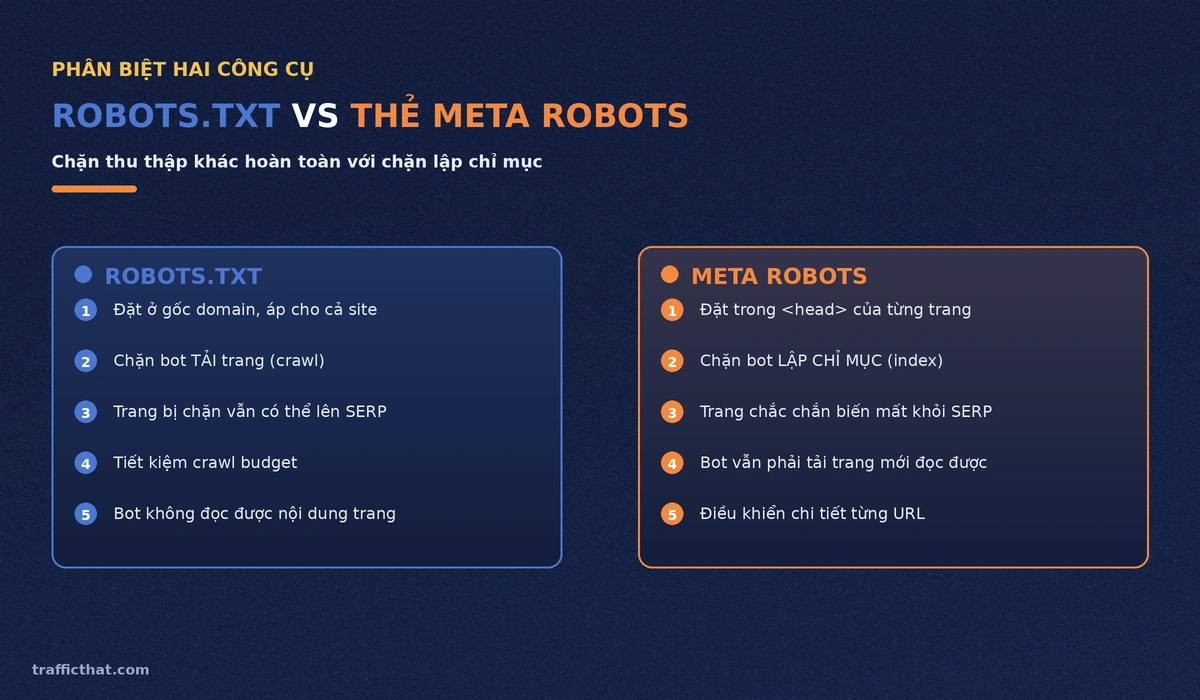
Rất nhiều người dùng lẫn lộn hai công cụ này vì cả hai đều “chặn Google”. Nhưng chúng chặn ở hai công đoạn hoàn toàn khác nhau trong quy trình của công cụ tìm kiếm.
Quy trình của Google gồm ba bước: crawl (tải trang) → index (đưa vào chỉ mục) → rank (xếp hạng). File robots.txt can thiệp ở bước 1, chặn bot tải trang. Thẻ meta robots can thiệp ở bước 2, chặn việc đưa trang vào chỉ mục.
| Tiêu chí | robots.txt | Thẻ meta robots |
|---|---|---|
| Vị trí | File duy nhất ở gốc domain | Trong <head> của từng trang |
| Chặn ở bước nào | Crawl — bot không tải trang | Index — bot tải nhưng không đưa vào chỉ mục |
| Trang còn lên SERP? | Có thể, nếu có backlink trỏ tới | Không, trang biến mất hoàn toàn |
| Tiết kiệm crawl budget | Có | Không (bot vẫn phải tải trang) |
| Phạm vi áp dụng | Theo pattern URL, cả nhóm trang | Chính xác từng URL |
Hệ quả thực tế: nếu bạn muốn một trang chắc chắn không xuất hiện trên Google, robots.txt là công cụ sai. Trang bị Disallow trong robots.txt mà có backlink trỏ tới vẫn có thể lên SERP dưới dạng kết quả trống với dòng “Không có thông tin cho trang này”. Google biết URL tồn tại (qua backlink) nhưng không được phép đọc nội dung, nên vẫn liệt kê URL.
Ngược lại, nếu bạn cần tiết kiệm crawl budget cho một site lớn hàng chục nghìn URL, meta robots không giúp gì — bot vẫn tải từng trang rồi mới đọc thấy noindex.
Bảng tra đầy đủ các giá trị directive
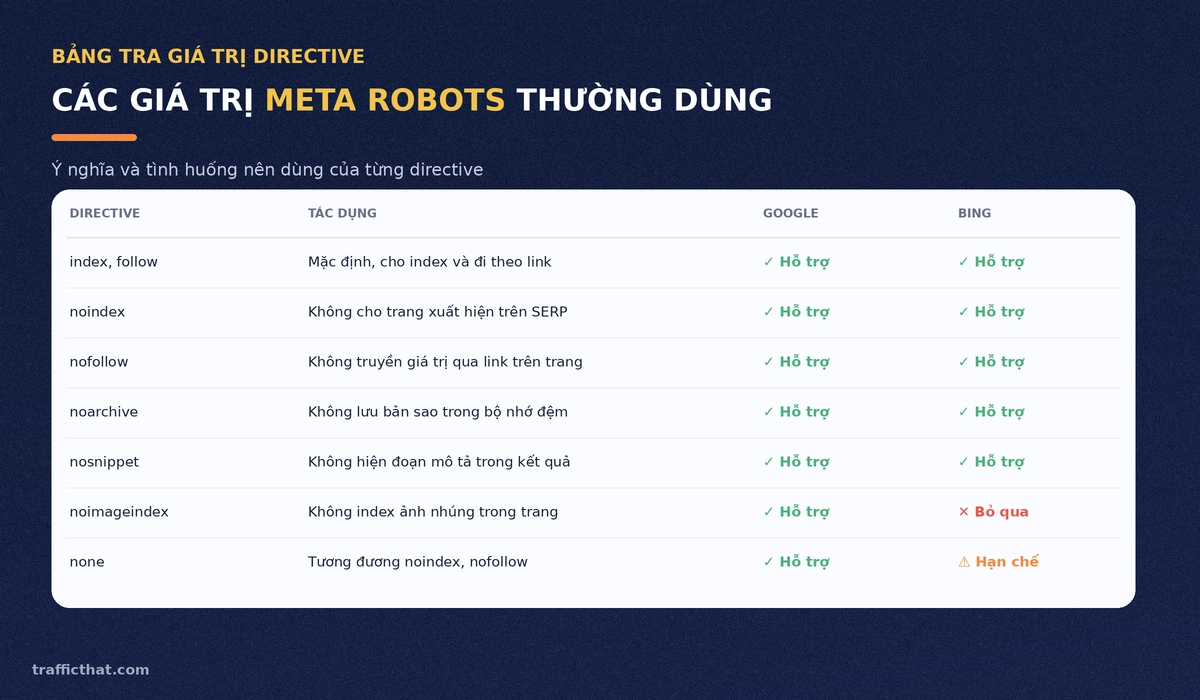
Ngoài bộ index/noindex/follow/nofollow quen thuộc, thẻ meta robots còn hỗ trợ nhiều directive kiểm soát chi tiết cách trang hiển thị trên SERP:
- noarchive — Google không lưu bản sao trang trong bộ nhớ đệm. Dùng cho trang có nội dung thay đổi liên tục như bảng giá, tỷ giá, tồn kho.
- nosnippet — không hiển thị đoạn mô tả trong kết quả tìm kiếm. Dùng rất hạn chế vì cắt mất đoạn mô tả sẽ kéo CTR xuống rõ rệt.
- max-snippet:[số] — giới hạn độ dài đoạn mô tả theo số ký tự. Giá trị
-1nghĩa là không giới hạn. - max-image-preview:[none|standard|large] — kiểm soát kích thước ảnh xem trước. Đặt
largegiúp bài có cơ hội hiển thị đẹp hơn trên Google Discover. - noimageindex — không lập chỉ mục ảnh nhúng trong trang. Cân nhắc kỹ nếu bạn đang khai thác traffic từ Google Image Search.
- notranslate — không đề nghị dịch trang trong kết quả tìm kiếm.
- unavailable_after:[ngày] — tự động gỡ trang khỏi chỉ mục sau một mốc thời gian. Hữu ích cho trang khuyến mãi có hạn.
- none — viết tắt của
noindex, nofollow. Nên viết đầy đủ thay vì dùngnoneđể tránh nhầm lẫn khi audit.
Có thể kết hợp nhiều directive trong một thẻ, ngăn cách bằng dấu phẩy: <meta name="robots" content="noindex, follow, noarchive">.
X-Robots-Tag: phiên bản HTTP header của meta robots
Thẻ meta robots là thẻ HTML, nên chỉ hoạt động với file HTML. Vậy làm sao để noindex một file PDF, một file ảnh, hay một file tài liệu tải về? Câu trả lời là X-Robots-Tag — cùng bộ directive nhưng gửi qua HTTP response header thay vì thẻ HTML.
Ví dụ cấu hình trên Apache để noindex toàn bộ file PDF:
- Thêm vào
.htaccesskhối<FilesMatch "\.pdf$">với chỉ thịHeader set X-Robots-Tag "noindex, nofollow". - Trên Nginx, dùng khối
location ~* \.pdf$vớiadd_header X-Robots-Tag "noindex, nofollow";.
X-Robots-Tag còn có một lợi thế nữa: áp dụng được cho cả nhóm URL theo pattern, không phải sửa từng trang. Với site lớn cần noindex hàng loạt trang phân trang hoặc trang lọc, đây là cách gọn hơn nhiều so với chỉnh từng bài.
Khi nào nên dùng noindex?
Noindex không phải là hình phạt, mà là công cụ dọn dẹp chỉ mục. Những nhóm trang dưới đây thường nên noindex:
- Trang kết quả tìm kiếm nội bộ — Google xem đây là nội dung mỏng tự sinh, dễ bị đánh giá thấp toàn site.
- Trang lọc, sắp xếp sản phẩm — tạo ra hàng nghìn URL gần trùng nhau. Nếu vẫn muốn giữ giá trị link, hãy cân nhắc thẻ canonical thay vì noindex.
- Trang giỏ hàng, thanh toán, tài khoản — không có giá trị tìm kiếm và có thể lộ dữ liệu.
- Trang cảm ơn sau chuyển đổi — nếu index, số liệu đo lường conversion sẽ bị nhiễu vì có người vào thẳng từ Google.
- Trang tag rỗng hoặc chỉ có 1-2 bài — không đủ nội dung để đứng độc lập.
- Bản nháp, trang thử nghiệm, staging site — nhóm này gây hại nhiều nhất vì tạo nội dung trùng lặp với site chính.
Ngược lại, tuyệt đối không noindex: trang danh mục có nội dung mô tả riêng, trang dịch vụ, bài blog chính, và các trang đang có thứ hạng. Một lần noindex nhầm trang đang có traffic là mất trắng thứ hạng đã xây nhiều tháng.
6 lỗi meta robots khiến website mất traffic

1. Chặn robots.txt cùng lúc với noindex. Đây là lỗi kinh điển và cực kỳ khó phát hiện. Nếu URL bị Disallow trong robots.txt, bot không tải được trang, nên không bao giờ đọc thấy thẻ noindex. Kết quả: trang vẫn nằm trong chỉ mục vĩnh viễn dù bạn đã đặt noindex. Muốn gỡ một trang, hãy mở robots.txt cho URL đó, để noindex phát huy tác dụng, chờ Google crawl lại rồi mới cân nhắc chặn.
2. Đặt noindex và canonical trỏ về nơi khác cùng lúc. Hai tín hiệu này mâu thuẫn: canonical nói “hãy index bản chính thay tôi”, noindex nói “đừng index gì cả”. Google có thể diễn giải theo cách bạn không mong muốn, thậm chí lan noindex sang cả URL canonical. Chọn một trong hai.
3. Bỏ quên noindex từ môi trường staging. Rất nhiều website WordPress bị noindex toàn site vì lập trình viên bật ô “Ngăn công cụ tìm kiếm lập chỉ mục trang web này” khi phát triển rồi quên tắt lúc lên production. Đây là việc cần kiểm tra ngay đầu tiên mỗi khi website đột ngột rớt thứ hạng hàng loạt.
4. Dùng noindex để xử lý nội dung trùng lặp. Noindex loại trang khỏi chỉ mục nhưng không gộp tín hiệu về bản chính. Với nội dung trùng lặp, canonical hoặc redirect 301 mới là công cụ đúng — chúng giữ và chuyển giá trị liên kết, còn noindex thì vứt bỏ.
5. Gỡ noindex quá sớm. Sau khi đặt noindex, Google cần crawl lại trang mới ghi nhận. Với trang ít quan trọng, việc này có thể mất vài tuần. Nếu bạn xoá thẻ noindex ngay khi trang biến mất khỏi SERP, nó sẽ quay lại chỉ mục ở lần crawl kế tiếp.
6. Nhầm nofollow cấp trang với rel=”nofollow” cấp link. Thẻ meta nofollow áp cho toàn bộ liên kết trên trang, còn thuộc tính rel="nofollow" chỉ áp cho một liên kết cụ thể. Nếu bạn chỉ muốn chặn vài link quảng cáo, hãy dùng rel=”nofollow” hoặc rel=”sponsored”, đừng đặt meta nofollow cho cả trang — làm vậy sẽ cắt luôn toàn bộ liên kết nội bộ đang điều hướng luồng crawl.
Cách cấu hình meta robots trên WordPress
WordPress mặc định không cho phép chỉnh meta robots từng bài, nên bạn cần plugin SEO. Hầu hết plugin phổ biến (Rank Math, Yoast, Slim SEO, SEOPress) đều có khu vực “Advanced” trong hộp cấu hình SEO ở cuối trình soạn thảo bài viết, với các công tắc bật/tắt cho noindex, nofollow, noarchive, nosnippet, noimageindex.
Ba mức cấu hình nên nắm:
- Mức toàn site — trong phần Cài đặt của plugin, bạn có thể noindex hàng loạt theo loại nội dung: tag, tác giả, trang lưu trữ theo ngày, kết quả tìm kiếm nội bộ. Đây là việc nên làm ngay khi dựng site, trước khi Google kịp index rác.
- Mức từng bài — ghi đè cấu hình toàn site cho một URL cụ thể.
- Mức server — X-Robots-Tag cho file không phải HTML.
Đặc biệt lưu ý ô Cài đặt → Đọc → “Ngăn công cụ tìm kiếm lập chỉ mục trang web này” của WordPress. Bật ô này sẽ thêm noindex, nofollow vào toàn bộ trang trên site. Đây là công tắc nguy hiểm nhất trong WordPress và cũng là thứ cần kiểm tra đầu tiên khi site không được index.
Cách kiểm tra thẻ meta robots đang hoạt động đúng
Đừng tin vào giao diện plugin — hãy kiểm tra trên trang thật:
- Xem mã nguồn trang. Nhấn Ctrl+U trên trình duyệt, tìm chuỗi
name="robots". Đây là cách nhanh và chính xác nhất. Nếu thấy hai thẻ robots cùng lúc, plugin của bạn đang xung đột với theme hoặc plugin khác — phải xử lý ngay vì Google sẽ áp dụng chỉ thị hạn chế nhất. - URL Inspection trong Google Search Console. Dán URL vào ô kiểm tra ở đầu Google Search Console, xem mục “Tình trạng lập chỉ mục”. Nếu bị chặn, công cụ sẽ báo rõ “Bị loại trừ theo thẻ ‘noindex'”. Đây là nguồn dữ liệu đáng tin nhất vì phản ánh đúng những gì Googlebot nhìn thấy.
- Báo cáo Lập chỉ mục → Trang. Mục “Bị loại trừ theo thẻ noindex” liệt kê toàn bộ URL đang bị chặn. Rà lại danh sách này định kỳ — nó thường phát hiện ra những trang bị noindex nhầm mà bạn không hề hay biết. Cách đọc chi tiết từng lý do loại trừ đã được phân tích trong bài khắc phục lỗi lập chỉ mục Search Console.
- Công cụ crawl toàn site. Screaming Frog hoặc Sitebulb cho phép quét cả website và lọc theo cột “Meta Robots” — cách duy nhất để phát hiện noindex rải rác trên site hàng nghìn trang.
Meta robots và chiến lược traffic tổng thể
Meta robots quyết định trang nào được phép nhận traffic từ Google. Nhưng dọn sạch chỉ mục mới chỉ là điều kiện cần. Sau khi các trang giá trị đã được index đúng, thứ hạng thực tế còn phụ thuộc vào tín hiệu hành vi người dùng trên chính những trang đó: thời gian ở lại, tỷ lệ nhấp, số trang mỗi phiên.
Nói cách khác, cấu hình meta robots chuẩn giúp bạn không tự bắn vào chân mình, còn việc đẩy trang lên top vẫn cần lượng truy cập thật đủ để Google có dữ liệu đánh giá. Bạn có thể xem thêm cách hai yếu tố này phối hợp trong bài tầm quan trọng của traffic user đến SEO.
Câu hỏi thường gặp
Thẻ meta robots có bắt buộc phải khai báo không?
Không. Nếu không có thẻ nào, công cụ tìm kiếm mặc định hiểu là index, follow. Bạn chỉ cần khai báo khi muốn thay đổi hành vi mặc định. Thêm <meta name="robots" content="index, follow"> vào mọi trang là thừa và không mang lại lợi ích SEO nào.
Đặt noindex bao lâu thì trang biến mất khỏi Google?
Phụ thuộc tần suất Google crawl trang đó. Trang quan trọng, có nhiều liên kết trỏ tới có thể biến mất trong vài ngày. Trang sâu, ít link có thể mất vài tuần đến một tháng. Nếu cần gỡ gấp, dùng công cụ “Xoá URL” trong Search Console để ẩn tạm thời khoảng 6 tháng, song song vẫn phải giữ thẻ noindex để việc gỡ có hiệu lực lâu dài.
Noindex có làm mất giá trị backlink trỏ về trang đó không?
Có. Trang bị noindex không còn trong chỉ mục nên không thể xếp hạng, và theo thời gian Google có xu hướng xem các liên kết trên trang noindex như nofollow. Nếu trang có backlink giá trị, hãy dùng redirect 301 về một trang tương đương thay vì noindex — cách này giữ lại phần lớn giá trị liên kết.
Nên dùng noindex hay canonical cho trang phân trang?
Google khuyến nghị để trang phân trang tự index bình thường (self-canonical), không noindex và không canonical về trang 1. Lý do: các sản phẩm hoặc bài viết ở trang 2, trang 3 cần được crawl để Google phát hiện. Noindex trang phân trang là cách nhanh nhất để một phần catalogue biến mất khỏi chỉ mục.
Meta robots có ảnh hưởng tới các công cụ AI như ChatGPT hay Perplexity không?
Có, nhưng theo cơ chế riêng. Các bot AI thường tuân theo directive dành riêng cho chúng (ví dụ GPTBot, Google-Extended) chứ không phải thẻ robots chung. Nếu muốn kiểm soát việc nội dung bị dùng để huấn luyện AI, bạn cần khai báo riêng cho từng user-agent trong robots.txt, đồng thời cân nhắc tác động tới khả năng xuất hiện trong AI Overviews của Google.
Kết luận
Thẻ meta robots là công tắc kiểm soát chỉ mục ở cấp độ từng trang — mạnh, chính xác, và cũng dễ gây hậu quả nghiêm trọng nếu dùng sai. Ba điều cần nhớ: robots.txt chặn crawl còn meta robots chặn index, không bao giờ dùng đồng thời cả hai cho cùng một URL, và luôn xác minh bằng URL Inspection thay vì tin vào giao diện plugin.
Sau khi chỉ mục đã sạch và đúng, bước tiếp theo là tạo tín hiệu người dùng thật để những trang giá trị nhất được Google ưu tiên xếp hạng. Nếu bạn đang cần nguồn traffic chất lượng để củng cố tín hiệu hành vi cho các trang mục tiêu, hãy tham khảo dịch vụ traffic search Google tại TrafficThat.com.


 Zalo