
Bạn đã tối ưu nội dung kỹ lưỡng, đã đi backlink, đã kéo traffic đều đặn nhưng thứ hạng vẫn giậm chân tại chỗ. Rất nhiều trường hợp như vậy có chung một nguyên nhân: website đang tồn tại hàng trăm lỗi kỹ thuật âm thầm mà bạn không nhìn thấy khi mở trình duyệt. Screaming Frog chính là công cụ giúp bạn nhìn website đúng theo cách Googlebot nhìn — và phát hiện toàn bộ những lỗi đó chỉ trong vài phút.
Screaming Frog là gì?
Screaming Frog SEO Spider là phần mềm cài trên máy tính (Windows, macOS, Ubuntu) có nhiệm vụ mô phỏng lại hành vi của một con bot tìm kiếm: nó xuất phát từ trang chủ, đi theo từng liên kết trên trang, ghi lại toàn bộ thông tin kỹ thuật của mỗi URL gặp được, rồi sắp xếp tất cả vào một bảng dữ liệu để bạn phân tích.
Khác với các công cụ SEO chạy trên nền web, Screaming Frog crawl bằng chính đường truyền và tài nguyên máy bạn. Điều này mang lại hai lợi thế lớn: dữ liệu là thời gian thực ngay tại thời điểm crawl (không phải dữ liệu cache của bên thứ ba), và bạn crawl được cả website đang ở môi trường staging, website chặn robots hoặc website yêu cầu đăng nhập.
Với mỗi URL, công cụ thu thập khoảng hơn 30 nhóm thông tin: mã trạng thái HTTP, thẻ tiêu đề, thẻ mô tả, cấu trúc heading, thẻ canonical, chỉ thị meta robots, dung lượng trang, thời gian phản hồi, số liên kết vào và ra, thuộc tính alt của ảnh… Toàn bộ dữ liệu này là nguyên liệu thô cho một quy trình audit website bài bản.
Vì sao SEOer nên dùng Screaming Frog?
Google Search Console cho bạn biết trang nào có vấn đề, nhưng thường báo chậm vài ngày và không nói rõ vấn đề nằm ở đâu trong mã nguồn. Screaming Frog lấp đúng khoảng trống đó với bốn giá trị thực tế:
- Phát hiện lỗi hàng loạt trong vài phút. Một website 3.000 trang được quét xong trong 10–20 phút, thay vì kiểm tra thủ công từng trang.
- Nhìn thấy cấu trúc liên kết thật. Bạn biết chính xác trang nào đang bị mồ côi (không có liên kết nội bộ nào trỏ tới), trang nào nằm quá sâu so với trang chủ.
- Kiểm chứng trước và sau khi sửa. Crawl lần một để ghi nhận hiện trạng, sửa xong crawl lại để đối chiếu — có bằng chứng số liệu rõ ràng.
- Tiết kiệm ngân sách thu thập dữ liệu. Phát hiện sớm các URL rác giúp bạn tối ưu crawl budget, để Googlebot dành thời gian cho những trang thực sự quan trọng.
5 bước crawl website đúng cách

Bước 1 — Cấu hình trước khi chạy. Vào Configuration để chọn chế độ Spider (crawl theo liên kết) hoặc List (chỉ crawl danh sách URL bạn dán vào). Nếu website lớn hơn 5.000 trang, bật chế độ lưu vào ổ cứng thay vì lưu trong RAM. Đồng thời giảm tốc độ crawl xuống khoảng 2–5 URL mỗi giây để không làm quá tải máy chủ — crawl quá nhanh có thể khiến hosting tạm khóa IP của bạn.
Bước 2 — Kết nối API. Trong mục API Access, kết nối tài khoản Google Analytics 4 và Google Search Console. Sau bước này, mỗi URL trong bảng kết quả sẽ có thêm cột lượt truy cập, số phiên, lượt hiển thị và số nhấp chuột. Đây là điểm khác biệt lớn: bạn không chỉ thấy lỗi, mà còn biết lỗi đó đang nằm trên trang có traffic hay trang không ai đọc, từ đó sắp xếp thứ tự ưu tiên xử lý hợp lý.
Bước 3 — Chạy crawl. Dán tên miền vào ô địa chỉ, bấm Start và chờ thanh tiến trình đạt 100%. Trong lúc chờ, bạn có thể mở tab Overview ở cột phải để theo dõi số lượng URL đã quét theo từng nhóm.
Bước 4 — Lọc lỗi theo mức độ ưu tiên. Đừng đọc lần lượt từ tab đầu tiên. Hãy vào thẳng Response Codes để xử lý lỗi 404 và chuỗi chuyển hướng trước, sau đó tới Directives để kiểm tra các trang bị đặt nhầm noindex, rồi mới tới nhóm lỗi nội dung.
Bước 5 — Xuất báo cáo. Dùng nút Export ở từng tab để tải file CSV. Với đội kỹ thuật, nên gộp thành một bảng duy nhất có ba cột: URL lỗi, mô tả lỗi và mức độ ưu tiên. Cách trình bày này giúp lập trình viên xử lý theo lô thay vì sửa lẻ tẻ từng trang.
Đọc tab nào để bắt lỗi gì?

Giao diện có hơn 20 tab, nhưng trong thực tế bạn chỉ cần nắm chắc sáu tab dưới đây là đã xử lý được phần lớn vấn đề kỹ thuật:
| Tab | Lỗi phát hiện được | Hướng xử lý |
|---|---|---|
| Response Codes | Trang trả về 404, chuỗi redirect nhiều bước, lỗi 5xx | Trỏ redirect 301 thẳng về URL đích cuối cùng |
| Page Titles | Thiếu tiêu đề, trùng tiêu đề, tiêu đề quá dài hoặc quá ngắn | Viết lại theo nguyên tắc tối ưu title và meta description |
| Meta Description | Bỏ trống hoặc trùng lặp hàng loạt | Bổ sung mô tả riêng cho từng trang quan trọng |
| Directives | Trang bị gắn nhầm noindex hoặc nofollow | Rà lại thẻ meta robots trên từng nhóm trang |
| Canonicals | Canonical trỏ sai, trỏ vòng hoặc thiếu | Chuẩn hóa lại để tránh nội dung trùng lặp |
| Images | Ảnh thiếu thuộc tính alt, ảnh dung lượng lớn | Áp dụng chuẩn tối ưu hình ảnh SEO |
Một tab ít người để ý nhưng rất giá trị là Internal. Cột “Crawl Depth” ở đây cho biết mỗi trang cách trang chủ bao nhiêu cú nhấp chuột. Nếu bài viết quan trọng nằm ở độ sâu 5 trở lên, khả năng cao Googlebot sẽ ít ghé thăm. Đây là lúc bạn cần xem lại chiến lược internal link để kéo các trang đó lên gần trang chủ hơn.
Bản miễn phí và bản trả phí khác nhau ra sao?
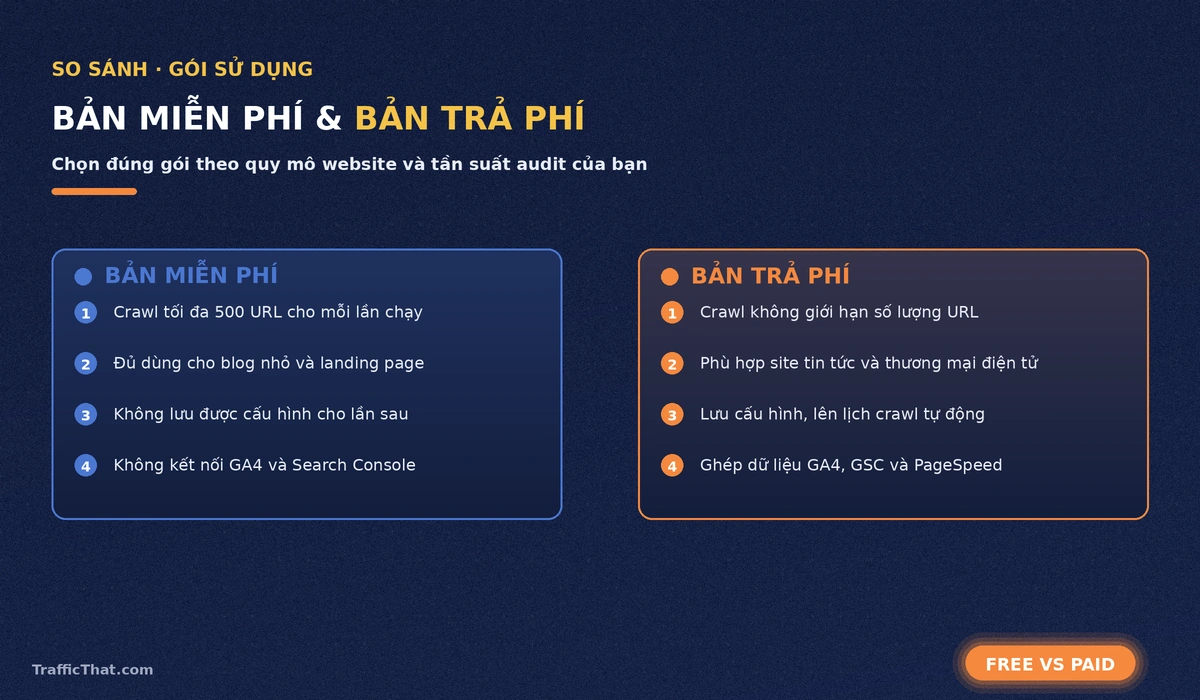
Bản miễn phí giới hạn 500 URL cho mỗi lần crawl. Con số này nghe nhỏ nhưng đủ dùng cho phần lớn blog cá nhân, website doanh nghiệp vừa và landing page. Hạn chế đáng kể nhất của bản miễn phí không nằm ở số lượng URL, mà ở chỗ bạn không lưu được cấu hình và không kết nối được API — nghĩa là mỗi lần mở phần mềm phải thiết lập lại từ đầu, và không ghép được dữ liệu traffic vào bảng kết quả.
Bản trả phí phù hợp khi bạn quản lý website thương mại điện tử, trang tin tức, hoặc làm dịch vụ cho nhiều khách hàng cùng lúc. Ngoài crawl không giới hạn, bạn có thêm khả năng lên lịch crawl tự động định kỳ, so sánh hai lần crawl khác nhau để thấy chính xác điều gì đã thay đổi, và render JavaScript cho các website dùng React hoặc Vue.
Bốn sai lầm thường gặp khi dùng Screaming Frog
- Crawl mà không giới hạn tham số URL. Website thương mại điện tử có bộ lọc sản phẩm thường sinh ra hàng chục nghìn URL biến thể. Nếu không loại trừ trong phần Configuration, bạn sẽ crawl mãi không xong và dữ liệu thu về gần như vô dụng.
- Nhầm lẫn giữa lỗi công cụ báo và lỗi thật. Screaming Frog tôn trọng file robots.txt theo mặc định. Một trang hiển thị “Blocked by robots.txt” có thể là đúng chủ đích của bạn. Hãy đối chiếu với cấu hình file robots.txt hiện tại trước khi kết luận đó là lỗi.
- Chỉ crawl một lần rồi thôi. Website luôn thay đổi. Nên đặt lịch crawl mỗi tháng một lần với site nhỏ, mỗi tuần một lần với site đăng bài liên tục.
- Sửa hết mọi lỗi cùng lúc. Không phải lỗi nào cũng đáng sửa. Một trang không có traffic, không có backlink, thiếu thẻ mô tả thì mức độ ưu tiên gần như bằng không. Hãy dùng dữ liệu Search Console đã ghép ở Bước 2 để lọc ra những trang thực sự đáng đầu tư thời gian.
Kết hợp Screaming Frog với Search Console
Hai công cụ này bổ sung cho nhau rất tốt. Search Console cho biết Google đã làm gì với website của bạn; Screaming Frog cho biết website đang trong tình trạng như thế nào ngay lúc này.
Quy trình phối hợp hiệu quả nhất: mở báo cáo Lập chỉ mục trong Search Console, tải danh sách URL thuộc nhóm “Đã phát hiện – hiện chưa được lập chỉ mục”, dán danh sách đó vào Screaming Frog ở chế độ List rồi crawl. Bạn sẽ thấy ngay nguyên nhân chung — có thể là canonical trỏ sai, có thể là các trang này đều bị nội dung mỏng, hoặc đơn giản là không trang nào có liên kết nội bộ trỏ tới. Đây là cách nhanh nhất để khắc phục lỗi lập chỉ mục trong Search Console theo lô thay vì mò mẫm từng URL.
Câu hỏi thường gặp
Screaming Frog có miễn phí không?
Có bản miễn phí vĩnh viễn, giới hạn 500 URL mỗi lần crawl và không hỗ trợ lưu cấu hình hay kết nối API. Bản trả phí tính theo năm, mở khóa toàn bộ tính năng và không giới hạn số URL.
Máy cấu hình yếu có chạy được không?
Được, nhưng nên chuyển chế độ lưu trữ từ RAM sang ổ cứng trong phần Configuration và giảm số luồng crawl xuống. Với máy 8GB RAM, bạn vẫn crawl thoải mái website vài nghìn trang nếu cấu hình đúng.
Crawl website của mình có bị Google phạt không?
Không. Screaming Frog chạy hoàn toàn trên máy bạn và chỉ gửi yêu cầu HTTP thông thường như một trình duyệt. Google không biết và cũng không quan tâm bạn có crawl website của chính mình hay không.
Có crawl được website của đối thủ không?
Được, miễn là website đó công khai và bạn để tốc độ crawl chậm để không gây tải bất thường. Tuy nhiên để phân tích chiến lược tổng thể của đối thủ, các công cụ chuyên biệt sẽ cho bức tranh đầy đủ hơn — tham khảo cách phân tích traffic đối thủ.
Bao lâu nên crawl lại một lần?
Website ít thay đổi thì mỗi quý một lần là đủ. Website đăng bài hàng ngày hoặc thương mại điện tử có tồn kho biến động nên crawl hàng tuần, và bắt buộc crawl ngay sau mỗi lần thay đổi cấu trúc URL hoặc chuyển đổi giao diện.
Kết luận
Screaming Frog không phải công cụ giúp bạn lên top ngay lập tức. Vai trò của nó là dọn sạch những rào cản kỹ thuật đang ngăn Googlebot đọc và đánh giá đúng website của bạn. Khi nền tảng kỹ thuật đã sạch, mọi khoản đầu tư vào nội dung, backlink và traffic mới phát huy hết hiệu quả.
Hãy bắt đầu đơn giản: tải bản miễn phí, crawl 500 URL quan trọng nhất, và xử lý dứt điểm hai nhóm lỗi ưu tiên cao nhất là mã trạng thái và chỉ thị meta robots. Chỉ riêng bước đó thôi cũng đã tạo ra khác biệt rõ rệt trong tốc độ Google thu thập và lập chỉ mục nội dung mới của bạn.


 Zalo