
Một bài viết mới xuất bản xong không tự động có mặt trên Google. Nó phải đi qua ba chặng: được phát hiện (discovery), được thu thập dữ liệu (crawl), rồi mới được đưa vào chỉ mục (index). Thực tế nhiều website mất từ một đến ba tuần cho toàn bộ chặng đường này, trong khi có website chỉ mất một hai ngày. Khác biệt nằm ở tín hiệu mà website đó gửi đi — và traffic user giúp index nhanh chính là một trong những tín hiệu được nhắc tới nhiều nhất, nhưng cũng bị hiểu sai nhiều nhất.
Bài viết này phân tích đúng bản chất mối quan hệ giữa lượt truy cập thật và tốc độ lập chỉ mục: cơ chế nào thực sự hoạt động, cơ chế nào chỉ là niềm tin dân gian, và cách mồi traffic cho bài mới sao cho có hiệu quả mà không tự tạo rủi ro.
Google quyết định thu thập một URL mới dựa trên điều gì?
Googlebot không có tài nguyên vô hạn. Với mỗi website, Google phân bổ một lượng tài nguyên thu thập gọi là crawl budget. Ngân sách này được điều chỉnh theo hai nhóm yếu tố:
- Crawl capacity limit — khả năng chịu tải của máy chủ. Server phản hồi nhanh, ổn định thì bot dám thu thập nhiều hơn.
- Crawl demand — mức độ Google muốn thu thập website đó. Đây là phần bị ảnh hưởng bởi độ phổ biến của URL, tần suất cập nhật nội dung và mức độ website được người dùng thực sự lui tới.
Vế thứ hai là chỗ traffic bước vào câu chuyện. Một tên miền có dòng người truy cập đều đặn, có các URL được truy cập lặp lại, được chia sẻ và được nhắc tới ở nơi khác sẽ tạo ra crawl demand cao hơn hẳn một tên miền im lìm. Khi crawl demand cao, bài mới trên tên miền đó được ghé thăm sớm hơn — đơn giản vì Google đang thu thập website đó thường xuyên hơn.
Điều quan trọng cần nói thẳng: Google không đọc số liệu Google Analytics của bạn để xếp hạng hay để quyết định thu thập. Google đã nhiều lần khẳng định GA không phải là yếu tố xếp hạng. Vậy cơ chế thật là gì?
Bốn cơ chế thật khiến traffic tác động lên tốc độ index
Thay vì tin vào một đường dây bí ẩn nối GA4 với thuật toán, hãy nhìn vào các cơ chế có thể quan sát và giải thích được.
1. Tín hiệu từ trình duyệt Chrome. Chrome chiếm phần lớn thị phần trình duyệt tại Việt Nam. Khi một URL mới được nhiều người mở trực tiếp trong Chrome, URL đó tồn tại trong hệ sinh thái dữ liệu của Google dưới dạng một địa chỉ có người ghé qua. Đây là kênh phát hiện URL không đi qua sitemap, và nó hoạt động ngay cả khi bạn chưa kịp khai báo gì.
2. Đường dẫn từ nguồn giới thiệu. Traffic không xuất hiện từ hư không. Nó đi từ một trang khác, một tin nhắn, một bài đăng. Những điểm xuất phát đó thường là các URL Google đã biết. Càng nhiều đường dẫn thật trỏ về bài mới, càng nhiều lối để bot bò tới.
3. Tín hiệu chất lượng sau khi được thu thập. Được crawl không đồng nghĩa với được index. Google vẫn có thể xếp URL vào nhóm “Đã thu thập dữ liệu — hiện chưa lập chỉ mục”. Ở bước quyết định này, các dấu hiệu cho thấy trang thực sự phục vụ người đọc — thời gian ở lại, hành vi cuộn, việc người dùng không lập tức quay ra SERP — góp phần củng cố đánh giá trang đáng được lưu vào chỉ mục. Đây chính là lý do tầm quan trọng của traffic user đến SEO không dừng ở con số lượt truy cập.
4. Hiệu ứng gián tiếp qua thứ hạng ban đầu. Bài được index sớm sẽ sớm có dữ liệu hiển thị trong Search Console, sớm có lượt hiển thị và nhấp, và vì thế sớm bước vào vòng đánh giá thật. Nó rút ngắn toàn bộ chu kỳ kiểm chứng nội dung.
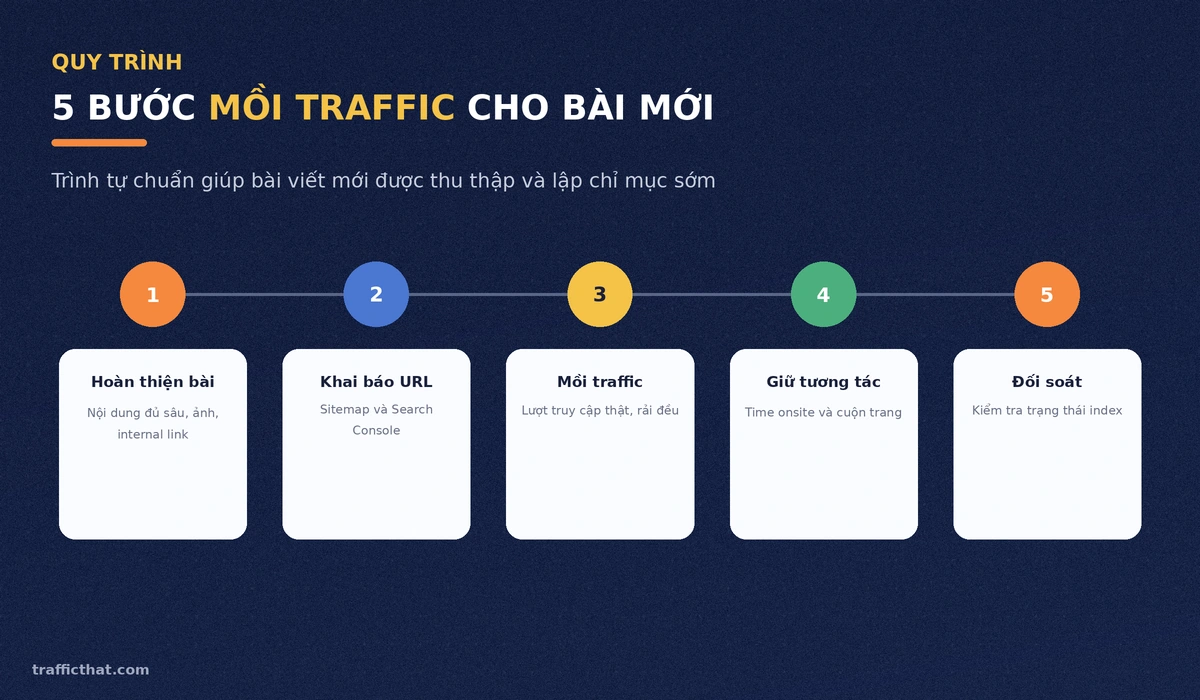
Quy trình 5 bước mồi traffic cho bài viết mới
Mồi traffic không phải là “bơm số”. Nó là chuỗi thao tác có trình tự, trong đó traffic chỉ là bước thứ ba.
Bước 1 — Hoàn thiện bài trước khi có người vào
Đây là bước bị bỏ qua nhiều nhất. Nếu bài chưa đủ sâu, chưa có ảnh, chưa có liên kết nội bộ, thì traffic đổ vào chỉ làm lộ ra điểm yếu: người đọc vào rồi thoát ngay, tạo tín hiệu ngược. Xây dựng hệ thống liên kết trước theo nguyên tắc trong bài internal link và cấu trúc link nội bộ để bot có nhiều đường dẫn tới URL mới ngay từ đầu.
Bước 2 — Khai báo URL đúng cách
Cập nhật sitemap và gửi URL qua công cụ Kiểm tra URL. Đây là kênh phát hiện nhanh và rẻ nhất, chi tiết thao tác nằm trong hướng dẫn Google Search Console toàn tập. Nếu URL bị báo lỗi hoặc bị loại trừ, xử lý theo cách khắc phục lỗi lập chỉ mục trước, đừng vội mồi traffic vào một URL đang bị chặn.
Bước 3 — Mồi traffic thật, rải đều
Chỉ đến đây mới đưa lượt truy cập vào. Nguồn có thể là mạng xã hội, email, cộng đồng, hoặc dịch vụ traffic user nếu bạn cần lưu lượng ổn định theo lịch. Điều cần giữ là tính tự nhiên của phân bố: rải theo giờ trong ngày, không dồn cục.
Bước 4 — Giữ tương tác thật trên trang
Một lượt truy cập chạm trang rồi thoát sau ba giây gần như không mang giá trị. Cần người đọc cuộn tới giữa bài, ở lại đủ lâu. Đây là khác biệt cốt lõi giữa các hình thức triển khai, xem thêm traffic user 1 bước, 2 bước và mã cố định.
Bước 5 — Đối soát và điều chỉnh
Sau 48–72 giờ, kiểm tra trạng thái URL trong Search Console và đối chiếu số phiên trong GA4. Nếu bài đã vào chỉ mục, giảm cường độ. Nếu chưa, tìm nguyên nhân kỹ thuật thay vì tăng traffic.
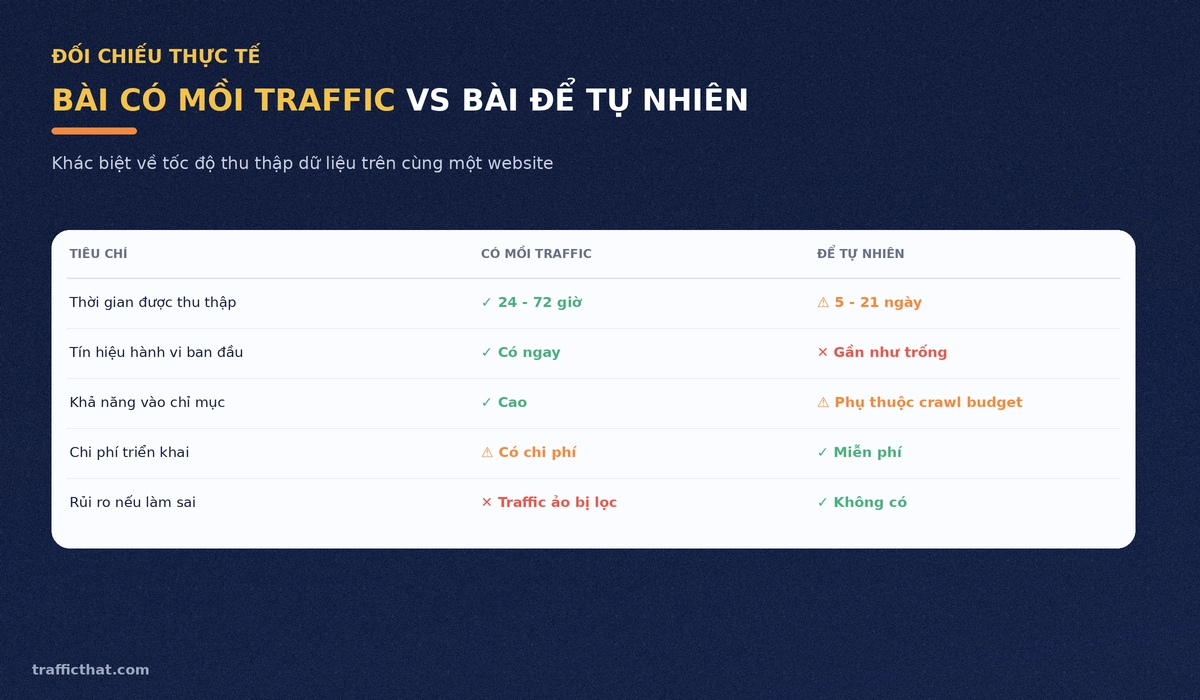
Bài có mồi traffic và bài để tự nhiên khác nhau ra sao?
Bảng dưới đây tổng hợp khác biệt thường quan sát được trên cùng một website, cùng một chất lượng nội dung:
| Tiêu chí | Bài có mồi traffic | Bài để tự nhiên |
|---|---|---|
| Thời gian được thu thập lần đầu | 24 – 72 giờ | 5 – 21 ngày |
| Tín hiệu hành vi giai đoạn đầu | Có ngay, đủ để đánh giá | Gần như trống |
| Khả năng vào chỉ mục | Cao hơn nếu nội dung đạt | Phụ thuộc crawl budget của site |
| Chi phí triển khai | Có chi phí | Miễn phí |
| Rủi ro nếu làm sai | Traffic ảo bị lọc, tín hiệu nhiễu | Không có |
Cần đọc bảng này đúng tinh thần: mồi traffic rút ngắn thời gian chờ, nó không biến một bài yếu thành bài được index. Nếu nội dung mỏng, mồi traffic chỉ khiến Google sớm nhìn thấy sự mỏng đó.
Vì sao traffic ảo không giúp gì cho việc index?
Đây là ranh giới quan trọng nhất của cả chủ đề. Traffic tạo bằng tool, bằng bot hoặc bằng máy chủ ảo có ba đặc điểm khiến nó vô dụng với mục tiêu index:
- Không đi qua trình duyệt thật. Không có phiên Chrome thật thì kênh phát hiện URL qua trình duyệt cũng không tồn tại.
- Không có hành vi. Vào rồi thoát tức thì, không cuộn, không chuyển trang — mô hình hành vi phẳng lỳ, dễ nhận diện.
- Dấu vết kỹ thuật lặp lại. Dải IP trung tâm dữ liệu, user-agent trùng nhau, thời điểm truy cập đều tăm tắp.
Hệ quả là các phiên này bị lọc khỏi báo cáo, và tệ hơn, làm nhiễu dữ liệu khiến bạn ra quyết định sai. Cách nhận diện chi tiết nằm trong bài traffic bot là gì và 7 dấu hiệu nhận biết.
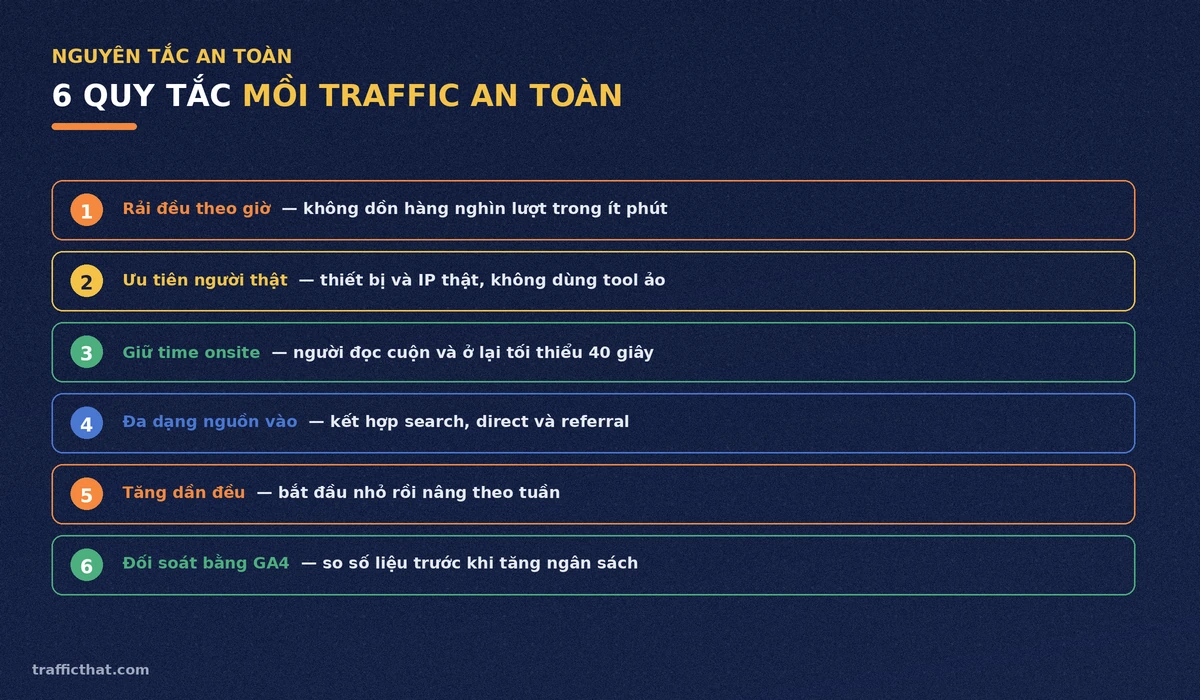
Sáu quy tắc mồi traffic an toàn
- Rải đều theo giờ. Phân bố lượt truy cập theo khung giờ người Việt thực sự online, không dồn nghìn lượt trong vài phút.
- Ưu tiên người thật. Thiết bị thật, IP dân cư hoặc 4G, có lịch sử duyệt web bình thường.
- Giữ time onsite tối thiểu. Đặt mục tiêu 40–90 giây cho bài dài, kèm hành vi cuộn.
- Đa dạng nguồn vào. Kết hợp search, direct và referral thay vì một kênh duy nhất.
- Tăng dần đều. Bắt đầu ở mức nhỏ rồi nâng theo tuần, tránh đường biểu đồ dựng đứng.
- Đối soát bằng GA4 trước khi tăng ngân sách. Tham khảo cách chia theo giai đoạn trong bài phân bổ ngân sách mua traffic user.
Khi nào nên mồi traffic, khi nào không cần?
Nên cân nhắc khi: website mới, tên miền chưa có lịch sử, crawl demand thấp; bài viết nhắm từ khóa có tính thời điểm cần index gấp; hoặc site vừa cấu trúc lại và cần tái thu thập diện rộng. Với website mới hoàn toàn, nên đọc thêm lộ trình trong bài tăng traffic cho website mới.
Chưa cần khi: website đã có lưu lượng ổn định và bài mới thường được index trong vòng 24 giờ; hoặc khi bài đang vướng lỗi kỹ thuật — lúc đó tiền bỏ ra chỉ mua thêm dữ liệu nhiễu.
Sai lầm thường gặp khi dùng traffic để ép index
- Mồi traffic vào URL đang bị noindex hoặc bị chặn robots.txt. Bot không vào được thì mọi lượt truy cập đều vô nghĩa.
- Chỉ mồi trang chủ. Traffic vào trang chủ giúp crawl demand chung, nhưng URL bài mới vẫn cần đường dẫn riêng.
- Dừng đột ngột. Biểu đồ tăng vọt rồi rơi thẳng đứng là mô hình bất thường, nên giảm dần thay vì cắt phăng.
- Coi traffic là thay thế cho nội dung. Đây là sai lầm đắt nhất và cũng phổ biến nhất.
Câu hỏi thường gặp
Traffic user có giúp bài được index trong 24 giờ không?
Có thể, nhưng không phải luôn luôn. Trong thực tế, khi bài đã hoàn thiện, đã khai báo URL và có liên kết nội bộ, việc kết hợp mồi traffic thường đưa thời gian thu thập về khoảng 24–72 giờ. Nếu website còn vướng lỗi kỹ thuật, con số này không cải thiện dù mồi bao nhiêu.
Google có đọc dữ liệu Google Analytics để quyết định index không?
Không. Google đã khẳng định GA không phải yếu tố xếp hạng. Tác động của traffic đi qua các kênh gián tiếp: phát hiện URL qua trình duyệt, đường dẫn từ nguồn giới thiệu, và các tín hiệu chất lượng ở bước quyết định lập chỉ mục.
Nên mồi bao nhiêu lượt cho một bài mới?
Không có con số cố định. Nguyên tắc là tương xứng với quy mô website: một site đang có 200 phiên mỗi ngày mà đột nhiên một bài mới nhận 5.000 lượt là bất thường. Mức khởi đầu hợp lý thường là 20–50 phiên mỗi ngày, rải trong 5–7 ngày.
Mồi traffic có bị Google phạt không?
Bản thân việc có người truy cập website không vi phạm nguyên tắc nào. Rủi ro nằm ở cách triển khai: dùng bot, tạo hành vi giả, hoặc bơm lưu lượng theo mô hình bất thường. Traffic thật, rải đều, có hành vi thật thì không tạo ra vấn đề.
Đã mồi traffic mà bài vẫn không được index thì làm gì?
Dừng mồi và chuyển sang chẩn đoán: kiểm tra thẻ meta robots, robots.txt, canonical trỏ sai, nội dung trùng lặp với bài cũ, và trạng thái cụ thể trong báo cáo Trang của Search Console. Gần như mọi trường hợp “mồi mãi không index” đều có nguyên nhân kỹ thuật hoặc nguyên nhân chất lượng nội dung.
Khi bài mới vẫn chưa được Googlebot ghé thăm, hãy rà soát lại toàn bộ kênh phát hiện URL theo hướng dẫn chi tiết về cách index bài viết nhanh trước khi kết luận website gặp lỗi kỹ thuật.
Kết luận
Mối quan hệ giữa traffic user và tốc độ index là mối quan hệ gián tiếp nhưng có thật. Traffic không phải công tắc bật chỉ mục, nó là yếu tố làm tăng crawl demand và cung cấp tín hiệu chất lượng ở đúng thời điểm Google đang cân nhắc có nên giữ URL của bạn trong chỉ mục hay không. Đặt traffic đúng chỗ trong quy trình — sau khi nội dung hoàn thiện và URL đã khai báo — thì nó rút ngắn thời gian chờ đáng kể. Đặt sai chỗ, nó chỉ là chi phí.


 Zalo