

Bạn viết bài đều đặn, onpage sạch sẽ, nhưng bài mới mất cả tuần mới được lập chỉ mục — trong khi đối thủ đăng buổi sáng, chiều đã thấy trên Google. Phần lớn trường hợp như vậy không phải do nội dung kém, mà do crawl budget của website bị tiêu hao vào những URL không đáng.
Bài viết này giải thích crawl budget là gì, Google phân bổ ngân sách thu thập dữ liệu dựa trên tiêu chí nào, cách đọc báo cáo Crawl stats để biết mình đang lãng phí ở đâu, và lộ trình 5 bước tối ưu áp dụng được cho cả blog nhỏ lẫn site thương mại điện tử hàng chục nghìn URL.
Crawl budget là gì?
Crawl budget (ngân sách thu thập dữ liệu) là số lượng URL mà Googlebot có thể và muốn thu thập trên website của bạn trong một khoảng thời gian nhất định. Hiểu đơn giản: mỗi ngày Googlebot chỉ dành một “hạn mức” hữu hạn cho site của bạn — nếu hạn mức đó bị đốt vào các trang tham số lọc, trang trùng lặp hay chuỗi redirect, thì những bài viết thật sự quan trọng sẽ phải xếp hàng chờ.
Ba điểm cần hiểu đúng ngay từ đầu:
- Crawl budget không phải yếu tố xếp hạng. Nó không giúp bạn lên top, nhưng nếu Googlebot không thu thập được trang, trang đó không thể được index — và không index thì không thể xếp hạng.
- Không phải website nào cũng cần lo về nó. Google nói rõ: site dưới vài nghìn URL, cập nhật bình thường, gần như không bao giờ chạm trần crawl budget. Vấn đề chỉ trở nên nghiêm trọng với site lớn, site thương mại điện tử nhiều tham số, hoặc site có server chậm.
- Nó gắn chặt với tốc độ được index. Đây là lý do crawl budget luôn xuất hiện khi bàn về mối quan hệ giữa traffic user và tốc độ index bài viết mới.
Hai thành phần cấu thành crawl budget
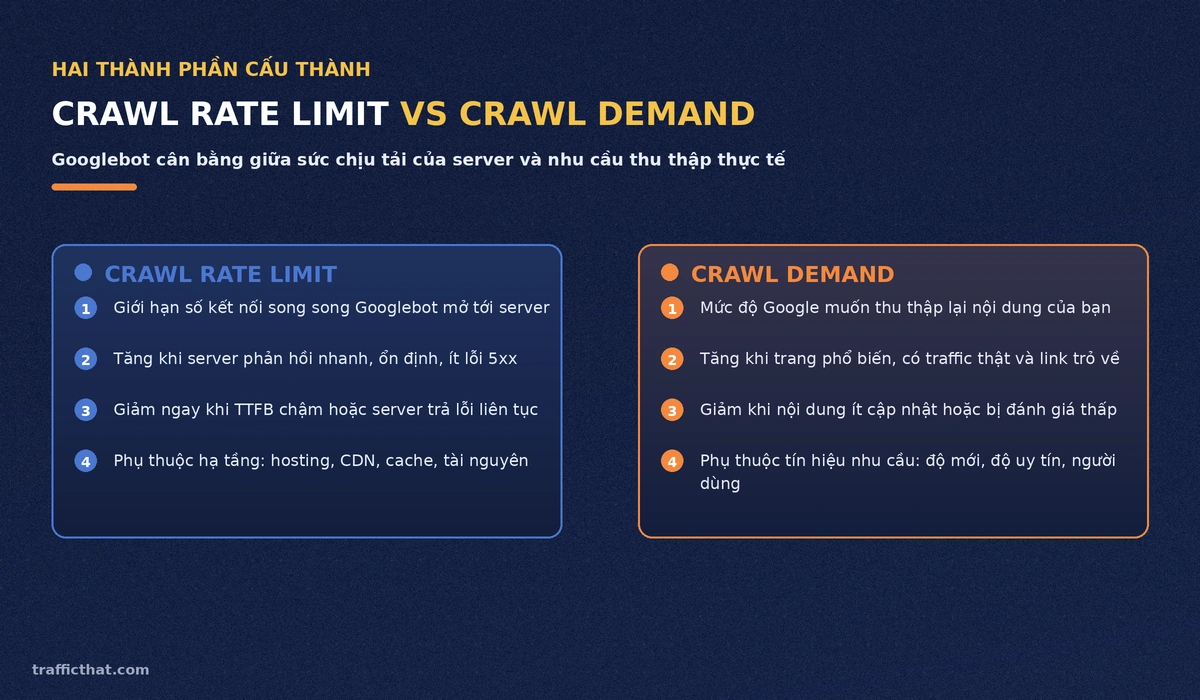
Google chia crawl budget thành hai vế độc lập nhưng cùng quyết định kết quả cuối cùng. Không nắm được cấu trúc này, bạn sẽ tối ưu sai chỗ: đổ công sức vào server trong khi vấn đề thật nằm ở nhu cầu, hoặc ngược lại.
Crawl rate limit — trần kỹ thuật
Đây là giới hạn số kết nối song song và tần suất Googlebot dám mở tới server của bạn. Google cố tình giữ mức này ở ngưỡng an toàn để không làm sập website. Cơ chế điều chỉnh rất trực tiếp:
- Server phản hồi nhanh, TTFB thấp, không lỗi → Google tăng dần tần suất.
- Server chậm dần, xuất hiện lỗi 5xx hoặc timeout → Google giảm ngay lập tức, đôi khi giảm rất mạnh.
Nghĩa là mọi nỗ lực tối ưu tốc độ tải trang đều có tác dụng kép: vừa cải thiện trải nghiệm người dùng, vừa nâng trần crawl budget. Đây cũng là lý do điểm số trong Google PageSpeed Insights và các chỉ số Core Web Vitals gián tiếp ảnh hưởng tới tốc độ index.
Crawl demand — nhu cầu thu thập
Trần kỹ thuật cao nhưng Google không muốn thu thập thì crawl budget thực tế vẫn thấp. Crawl demand phản ánh mức độ Google cho rằng nội dung của bạn đáng được ghé lại. Ba yếu tố chính:
- Độ phổ biến: URL có nhiều liên kết trỏ về và có lượt truy cập thật thường được ghé thăm thường xuyên hơn.
- Độ mới: Google cố tránh để bản sao trong index bị cũ. Trang thay đổi đều đặn sẽ được quay lại nhanh hơn.
- Chất lượng tổng thể của site: nếu phần lớn URL bị đánh giá là mỏng hoặc trùng lặp, Google sẽ hạ nhu cầu thu thập cho toàn bộ tên miền — không riêng các trang kém.
Điểm cuối cùng đáng chú ý với ai đang chạy chiến dịch traffic: tín hiệu người dùng thật sự góp phần duy trì crawl demand ở mức cao, tương tự cách chúng tôi phân tích trong bài tầm quan trọng của traffic user đến SEO.
Những gì thật sự ăn mòn crawl budget
Google từng công bố danh sách các nhóm URL “giá trị thấp” làm hao ngân sách thu thập. Bảng dưới tóm tắt các trường hợp gặp nhiều nhất tại thị trường Việt Nam, kèm hướng xử lý tương ứng.

| Nguyên nhân lãng phí | Biểu hiện thường thấy | Cách xử lý |
|---|---|---|
| URL tham số (lọc, sắp xếp, phân trang) | Hàng nghìn URL dạng ?color=red&sort=price | Gắn canonical về bản gốc, chặn tổ hợp vô nghĩa trong robots.txt |
| Nội dung trùng lặp | Nhiều URL cùng nội dung, khác đường dẫn | Gộp bài, dùng canonical, xử lý triệt để tình trạng keyword cannibalization |
| Trang mỏng, tự sinh | Trang tag rỗng, trang kết quả tìm kiếm nội bộ | Noindex hoặc chặn crawl các trang không có giá trị tìm kiếm |
| Chuỗi redirect dài | URL A → B → C → D | Rút về một bước duy nhất, cập nhật lại link nội bộ |
| Soft 404 và lỗi máy chủ | Trang trắng trả mã 200, lỗi 5xx rải rác | Trả đúng mã trạng thái, xử lý lỗi hạ tầng trước tiên |
| Không gian URL vô hạn | Lịch, bộ lọc lồng nhau không giới hạn | Giới hạn độ sâu, chặn mẫu URL bằng robots.txt |
Một hiểu lầm phổ biến: nhiều người dùng thẻ noindex để tiết kiệm crawl budget. Thực tế Googlebot vẫn phải tải trang về mới đọc được thẻ đó — nghĩa là ngân sách vẫn bị tiêu. Muốn chặn ở tầng thu thập, phải dùng robots.txt; còn noindex chỉ giải quyết ở tầng lập chỉ mục.
Cách kiểm tra crawl budget của website
Báo cáo Crawl stats trong Google Search Console (Settings → Crawl stats) là nguồn dữ liệu chính thức duy nhất. Nếu chưa quen công cụ này, bạn nên đọc trước bài hướng dẫn Google Search Console toàn tập.
Bốn chỉ số cần đọc theo thứ tự:
- Total crawl requests: tổng số yêu cầu mỗi ngày. Đường xu hướng đi xuống liên tục trong nhiều tuần là dấu hiệu cảnh báo.
- Average response time: thời gian phản hồi trung bình. Con số này tăng lên trong khi số yêu cầu giảm xuống gần như luôn đồng nghĩa server đang là nút thắt.
- By response — phân bổ theo mã trạng thái: tỷ lệ 200 nên chiếm áp đảo. Nếu 301, 404 hay 5xx chiếm phần lớn, bạn đang trả tiền để Googlebot đi vào ngõ cụt.
- By file type và by purpose: phân biệt giữa refresh (ghé lại trang cũ) và discovery (khám phá trang mới). Site đăng bài đều mà tỷ lệ discovery thấp là dấu hiệu trang mới khó được tìm thấy.
Đối chiếu song song với báo cáo Page indexing sẽ cho bức tranh đầy đủ hơn. Các lỗi thường gặp ở đây được phân tích chi tiết trong bài khắc phục lỗi trang chưa được lập chỉ mục.
Lộ trình 5 bước tối ưu crawl budget

Bước 1 — Đo hiện trạng trước khi sửa bất cứ thứ gì
Ghi lại ba con số nền: số yêu cầu trung bình mỗi ngày trong 30 ngày qua, thời gian phản hồi trung bình, và tỷ lệ phần trăm các mã trạng thái. Không có mốc gốc thì sau này bạn không thể biết việc mình làm có tác dụng hay không.
Song song, xuất danh sách toàn bộ URL đang tồn tại (từ sitemap, từ CMS, từ công cụ crawl) và so với danh sách URL đã được index. Khoảng chênh giữa hai con số này chính là phần cần điều tra.
Bước 2 — Dọn sạch URL rác
Đây là bước mang lại hiệu quả nhanh nhất. Thứ tự ưu tiên:
- Chặn các mẫu URL tham số vô nghĩa trong robots.txt (làm cẩn thận, sai một dòng có thể chặn nhầm cả site).
- Gắn canonical đúng cho các biến thể URL cùng nội dung.
- Rút gọn mọi chuỗi redirect về một bước.
- Gỡ hoặc sửa các link nội bộ đang trỏ tới URL 404.
- Noindex các trang tự sinh không có giá trị tìm kiếm: trang tag rỗng, trang kết quả tìm kiếm nội bộ, trang phân trang sâu.
Bước 3 — Nâng trần bằng tốc độ server
Mục tiêu cụ thể: đưa thời gian phản hồi trung bình trong Crawl stats xuống dưới 300ms. Các việc thường cho kết quả rõ nhất là bật cache toàn trang, dùng CDN, tối ưu truy vấn cơ sở dữ liệu và nâng cấp gói hosting nếu đang dùng shared hosting quá tải.
Cải thiện ở bước này thường thấy kết quả sau 2–4 tuần: Googlebot tự động tăng tần suất khi nhận thấy server phản hồi ổn định hơn.
Bước 4 — Dẫn luồng thu thập về đúng chỗ
Sau khi dọn rác và nâng trần, việc còn lại là chỉ đường. Sitemap XML chỉ nên chứa URL trả 200, có canonical trỏ về chính nó, và cần cập nhật lastmod chính xác — khai báo lastmod sai sự thật sẽ khiến Google dần bỏ qua tín hiệu này.
Quan trọng không kém là cấu trúc liên kết nội bộ: trang càng ít cú click từ trang chủ thì càng được ghé thăm thường xuyên. Nguyên tắc xây dựng luồng này được trình bày đầy đủ trong bài chiến lược internal link và mô hình topic cluster.
Bước 5 — Theo dõi và duy trì nhịp
Sau 30 ngày, mở lại Crawl stats và so với mốc gốc ở bước 1. Dấu hiệu tích cực: số yêu cầu tăng, thời gian phản hồi giảm, tỷ lệ mã 200 tăng, tỷ lệ discovery cao hơn.
Đây cũng là lúc duy trì crawl demand bằng cách cập nhật nội dung đều đặn và giữ dòng truy cập thật ổn định về các trang quan trọng — cách tiếp cận được mô tả trong bài mồi tín hiệu cho website mới.
Website nào thật sự cần tối ưu crawl budget?
Không phải ai cũng cần bỏ công cho việc này. Dùng khung sau để tự đánh giá:
- Dưới 1.000 URL, server ổn định: gần như không cần quan tâm. Hãy tập trung vào chất lượng nội dung và internal link.
- Từ 1.000 đến 10.000 URL: nên kiểm tra Crawl stats định kỳ mỗi quý, chủ yếu để phát hiện sớm URL tham số phát sinh ngoài ý muốn.
- Trên 10.000 URL hoặc site thương mại điện tử có bộ lọc: tối ưu crawl budget là việc bắt buộc, làm định kỳ hàng tháng.
- Site cập nhật liên tục (tin tức, tuyển dụng, bất động sản): ưu tiên hàng đầu, vì giá trị nội dung giảm nhanh theo thời gian.
Nếu website của bạn nhỏ nhưng bài mới vẫn chậm được index, nguyên nhân nhiều khả năng không nằm ở crawl budget mà ở chất lượng nội dung hoặc tín hiệu tin cậy. Trường hợp này nên đọc bài website không có traffic — nguyên nhân và cách khắc phục trước khi động vào robots.txt.
Câu hỏi thường gặp
Crawl budget có phải là yếu tố xếp hạng không?
Không. Google đã xác nhận crawl budget không nằm trong các yếu tố xếp hạng. Tuy nhiên nó là điều kiện cần: trang không được thu thập thì không được lập chỉ mục, và không lập chỉ mục thì không thể xuất hiện trên kết quả tìm kiếm.
Chặn URL bằng robots.txt có làm mất thứ hạng không?
Chỉ khi bạn chặn nhầm trang đang có thứ hạng. Với URL tham số, trang lọc hay trang tự sinh không ai tìm kiếm thì việc chặn hoàn toàn an toàn. Trước khi áp dụng, hãy kiểm tra trong Search Console xem mẫu URL định chặn có đang mang lại lượt hiển thị nào không.
Bao lâu thì thấy kết quả sau khi tối ưu?
Thay đổi liên quan tới tốc độ server thường phản ánh vào Crawl stats sau 2–4 tuần. Thay đổi về cấu trúc URL và robots.txt có thể mất 4–8 tuần để Google xử lý hết, đặc biệt với site nhiều URL.
Số lượt truy cập thật có làm tăng crawl budget không?
Không trực tiếp. Nhưng traffic thật đi kèm tín hiệu tương tác tốt giúp Google đánh giá trang là phổ biến và đáng ghé lại — tức là tác động vào vế crawl demand. Đây là quan hệ gián tiếp, không nên kỳ vọng thành công cụ ép index tức thời.
Sitemap XML có làm tăng crawl budget không?
Sitemap không làm tăng hạn mức, nhưng giúp Googlebot tiêu hạn mức đó đúng chỗ. Một sitemap sạch, chỉ chứa URL trả 200 và có lastmod chính xác, luôn hiệu quả hơn một sitemap liệt kê toàn bộ URL kể cả trang lỗi.
Muốn biết chính xác Googlebot đang lãng phí ngân sách thu thập vào những URL nào, bạn nên crawl lại toàn site bằng phần mềm chuyên dụng — hướng dẫn chi tiết có trong bài Screaming Frog là gì.
Một trong những nguồn lãng phí ngân sách thu thập dễ bị bỏ qua nhất là các URL hỏng và soft 404 nằm rải rác trong cấu trúc site. Hãy đọc thêm cách kiểm tra và xử lý lỗi 404 Not Found để thu hồi phần lượt crawl đang bị đổ vào những đường dẫn không còn tồn tại.
Muốn hiểu tận gốc vì sao ngân sách thu thập dữ liệu bị tiêu hao, bạn nên nắm trước cơ chế hoạt động của Googlebot qua bốn giai đoạn crawl, render, index và rank.
Một nguyên nhân âm thầm làm hao ngân sách thu thập là website phụ thuộc quá nhiều vào JavaScript, khiến mỗi URL tốn gấp nhiều lần tài nguyên render; bài JavaScript SEO phân tích kỹ cách giảm chi phí này.
Kết luận
Crawl budget không phải thứ bạn “mua” thêm được, mà là thứ bạn tiêu đúng chỗ hoặc tiêu lãng phí. Với đa số website vừa và nhỏ, chỉ cần dọn URL rác, giữ server nhanh và duy trì cấu trúc liên kết nội bộ mạch lạc là đủ để Googlebot không bao giờ trở thành nút thắt.
Với site lớn, hãy biến việc đọc Crawl stats thành thói quen hàng tháng — phát hiện sớm một mẫu URL tham số phát sinh ngoài ý muốn có thể tiết kiệm hàng tháng chờ đợi index. Và đừng quên rằng chỉ số kỹ thuật chỉ mở đường; thứ giữ được thứ hạng vẫn là nội dung hữu ích cùng dòng người dùng thật quay lại đều đặn.


 Zalo